Nasz najtrudniejszy test end-to-end potrafił czekać na agenta czterdzieści minut. Pierwsza wersja dawała mu timeout na osiemdziesiąt minut. Kiedy przebieg przestawał robić cokolwiek pożytecznego, często czekałem przez większość tego czasu, zanim się o tym dowiedziałem.
Ciągle wracałem myślami do Dujiangyan. UNESCO opisuje system nawadniający, który zaczęto budować w III wieku p.n.e. i który reguluje przepływ rzeki bez tamy. Działa do dziś i wciąż się go konserwuje.
To porównanie przydało mi się przy jednej decyzji w teście. Potrzebowałem sygnału od działającego procesu, a nie kolejnego zgadywania, ile ten proces powinien trwać.
Test steruje OwlMeans przez przeglądarkę. Rejestruje użytkownika, wysyła prompt, czeka na specyfikację i ją zatwierdza. Dla projektu startuje nowa piaskownica w Kubernetesie. Potem agent realizuje pierwszą user story.
W przebiegach, na których opiera się ten czerwcowy artykuł, ostatni krok trwał od dziesięciu do czterdziestu minut.
Gdybym zamockował model, test odpowiadałby na inne pytanie. Tutaj chciałem wiedzieć, czy przeglądarka, pipeline i środowisko projektu razem przejdą cały proces.
Do testów w przeglądarce używamy @owlmeans/test-ui, nakładki na Playwrighta. Logowanie w teście idzie przez nasz mechanizm supervisora, więc akurat ten test nie dowodzi, że działa prawdziwe logowanie przez Google.
Piaskownicę tworzy @owlmeans/kephemeral. Przygotowuje tymczasową przestrzeń nazw, pamięć masową, workload i politykę sieciową. Pilnuje też workloadu i potrafi przywrócić poda, który padł.
Takie przywracanie pomaga utrzymać dostępność środowiska. Nie mówi jednak testowi, czy odpowiedź agenta jest poprawna.
Pętla oczekiwania
Agent zużywa tokeny, kiedy pracuje. Zmiany zapisanego salda traktowałem jako znak, że przebieg wciąż trwa.
Test odczytywał saldo co dwadzieścia sekund. Dopóki się zmieniało, detektor pozwalał czekać dalej. Jeśli przez dziesięć minut stało w miejscu, detektor uznawał, że przebieg mógł utknąć, i kończył go błędem.
Była to heurystyka żywotności dobrana do naszego pipeline’u. Zmieniające się saldo może oznaczać pracę, z której nic nie wynika. Saldo, które stoi w miejscu, może też oznaczać uzasadnione czekanie, opóźnione naliczanie albo problem poza modelem.
Nadal potrzebowałem asercji dla oczekiwanego stanu user story i zachowania przeglądarki. Samo wydawanie tokenów tych asercji nie spełni.
Progi dobrałem do czerwcowego procesu i nie zalecałbym ich innemu zespołowi jako wartości domyślnych. Zapisz, jakie sygnały faktycznie wysyła Twoja długo trwająca operacja, a potem zdecyduj, jak długa cisza wymaga już sprawdzenia.
Wytyczne Playwrighta dotyczące testowania też kładą nacisk na izolację testów. Nasze powolne czekanie było tylko jednym ze źródeł zawodnych przebiegów.
Porzucona piaskownica
Test przerwany po przygotowaniu środowiska może zostawić po sobie projekt. Następny przebieg zastaje wtedy środowisko, którego test nie zamierzał tworzyć.
Używaliśmy wciąż tego samego profilu testowego. Przed każdym przebiegiem i po nim kod testów usuwał projekty testowe tego profilu. Sprzątanie przed przebiegiem było ważne, bo poprzedni proces mógł w ogóle nie dojść do etapu, w którym sprząta po sobie.
Zakres usuwania musi pozostać wąski. Procedura sprzątania, która sięga do niezwiązanych projektów, byłaby problemem znacznie gorszym niż niestabilny test.
Zgłaszaj nieudane sprzątanie. Jeśli zasoby zostały, a następny test rusza tak, jakby sprzątanie się powiodło, przydatne dowody znikają z pola widzenia. Zanim pójdziesz dalej, sprawdź rzeczywisty stan początkowy.
W tej konfiguracji usunęło to powracające źródło zakłóceń. Późniejsze awarie i tak trzeba było badać.
Droga do domu
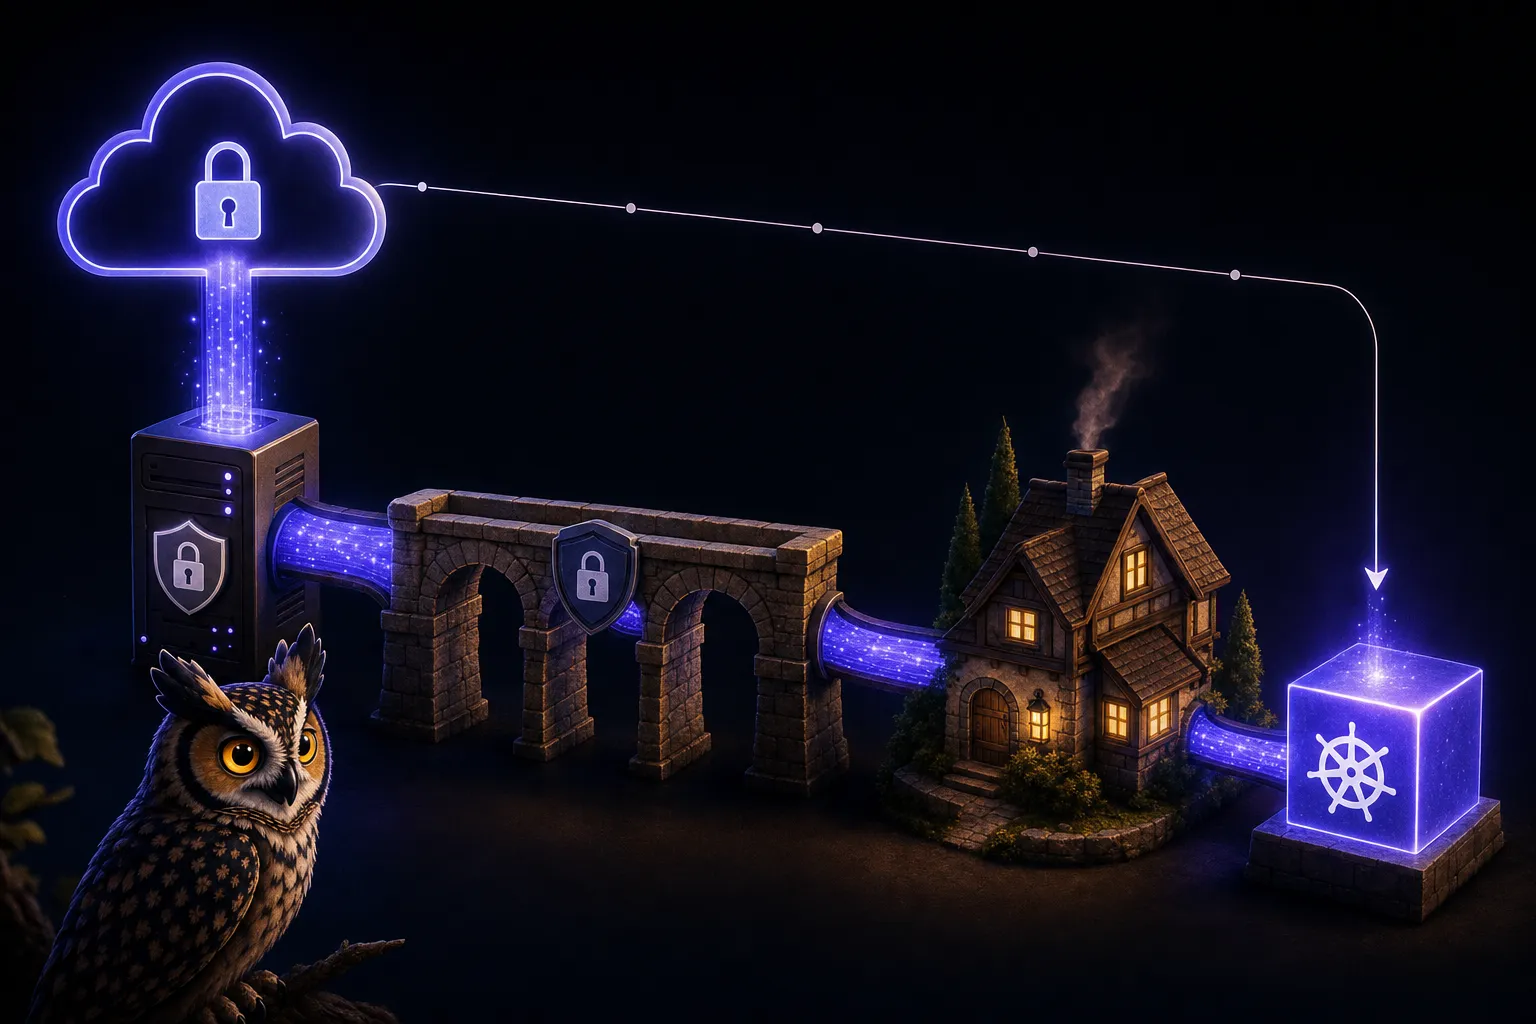
Klaster działał na serwerze w domu, za łączem od dostawcy internetu, które nie dawało użytecznego publicznego adresu dla ruchu przychodzącego.
Nasza trasa korzystała z maszyny wirtualnej w chmurze z zarezerwowanym publicznym IP, proxy Nginx i WireGuarda. Ruch szedł z Cloudflare do serwera pośredniczącego, szyfrowanym tunelem do domowego serwera, a stamtąd do usługi w Kubernetesie.
Tak wyglądał nasz układ z serwerem pośredniczącym. Nie myl go z sytuacją, w której cały transport zapewnia konektor Cloudflare Tunnel.
Trasę konfigurowały Terraform, Ansible i skrypty powłoki. Watchdog co sześćdziesiąt sekund sprawdzał reguły zapory i naprawiał dryf konfiguracji, który rozpoznał. Potrafił przywrócić konkretne reguły. Sieć i tak mogła paść.
Zarezerwowany adres miał się nie zmieniać mimo rozbiórek środowiska opisanych w konfiguracji. Stan u dostawcy, dane uwierzytelniające i konfiguracja nadal wymagały utrzymania.
Awaria sieci powinna teraz zostawiać mi do zbadania właśnie awarię sieci. Dłuższe czekanie na agenta nie naprawi zerwanej trasy do jego środowiska.
Dzięki tej pracy test łatwiej diagnozować. Potrafiłem odróżnić milczącego agenta, porzuconą piaskownicę i zerwaną drogę do klastra, zamiast dawać wszystkim trzem kolejną godzinę.
Skrót logowania, biblioteka do tworzenia środowisk, uprawnienia do sprzątania, rozliczanie tokenów i konfiguracja sieci nadal wymagają utrzymania. Zmiana w którymkolwiek z tych elementów może unieważnić jakieś założenie testu.
Usługi OwlMeans mogą obejmować taką infrastrukturę wdrożeniową i testową. Praca musi pasować do rzeczywistego stosu technologicznego i do tego, jak dany system zawodzi; czerwcowa konfiguracja nie jest obietnicą, że wdrożymy dowolny system w kilka dni.
Czas spędzany na czekaniu zamieniłem na czas poświęcany utrzymaniu zaplecza testów. W tym procesie to się opłaciło.
Pierwsza publikacja: 23 czerwca 2026 r. Poprawiono 15 października 2026 r., żeby oddzielić detektor żywotności od sprawdzania poprawności i dodać zastrzeżenia do twierdzeń o infrastrukturze.