Nuestra prueba de extremo a extremo más difícil podía pasarse cuarenta minutos esperando a un agente. La primera versión le daba un timeout de ochenta minutos. Cuando la ejecución dejaba de hacer trabajo útil, muchas veces no me enteraba hasta que había pasado la mayor parte de ese tiempo.
No dejaba de pensar en Dujiangyan. Según la descripción de la UNESCO, es un sistema de riego que se empezó a construir en el siglo III a. C. y que controla el caudal del río sin presa. Sigue en uso y recibe mantenimiento.
La comparación me sirvió para una decisión concreta de la prueba. Necesitaba una señal del proceso en marcha, no otra conjetura sobre cuánto debería tardar.
La prueba controla OwlMeans desde el navegador. Registra un usuario, envía un prompt, espera la especificación y la confirma. Para el proyecto arranca un nuevo sandbox de Kubernetes. Después, un agente desarrolla la primera historia de usuario.
En las ejecuciones en las que se basa este artículo de junio, ese último paso tardaba entre diez y cuarenta minutos.
Simular el modelo respondería a otra pregunta. Aquí quería saber si el navegador, el pipeline y el entorno del proyecto podían completar juntos el flujo.
El arnés de pruebas del navegador envuelve Playwright con @owlmeans/test-ui. Su inicio de sesión de prueba usa nuestro mecanismo de supervisor, así que esta prueba en concreto no demuestra que funcione un inicio de sesión real con Google.
El sandbox sale de @owlmeans/kephemeral, que aprovisiona el espacio de nombres temporal, el almacenamiento, la carga de trabajo y la política de red. La biblioteca también vigila la carga de trabajo y puede recuperar un pod caído.
Esa recuperación ayuda a que el entorno siga disponible. No le dice a la prueba si la respuesta del agente es correcta.
El bucle de espera
El agente consume tokens mientras trabaja. Usé los cambios en el saldo registrado como señal de que la ejecución seguía activa.
La prueba consultaba ese saldo cada veinte segundos. Si seguía cambiando, el detector dejaba que la espera continuara. Si se quedaba quieto diez minutos, el detector daba la ejecución por fallida, por posible atasco.
Era una heurística de actividad pensada para nuestro pipeline. Un saldo que cambia puede significar trabajo improductivo. Un saldo quieto también puede significar una espera legítima, una contabilidad con retraso o un problema ajeno al modelo.
Me seguían haciendo falta aserciones sobre el estado esperado de la historia y sobre el comportamiento del navegador. Gastar tokens no puede satisfacer esas aserciones.
Los umbrales eran decisiones para el flujo de junio, no valores por defecto que yo recomendaría a otro equipo. Registra lo que emite de verdad tu operación de larga duración y luego decide cuánto silencio justifica investigar.
Las recomendaciones de Playwright sobre pruebas también insisten en aislarlas. Nuestra espera lenta era solo una de las fuentes de ejecuciones poco fiables.
El sandbox abandonado
Si interrumpes una prueba después del aprovisionamiento, puede dejar un proyecto olvidado. La siguiente ejecución se encuentra entonces con un entorno que la prueba no pretendía crear.
Reutilizábamos un único perfil de prueba. Antes y después de cada ejecución, el arnés destruía los proyectos de prueba de ese perfil. La limpieza previa importaba porque el proceso anterior quizá nunca había llegado a la fase de desmontaje.
El alcance del borrado tiene que mantenerse acotado. Una rutina de limpieza que llegue a proyectos ajenos sería un problema mucho peor que una prueba inestable.
Informa de los fallos de limpieza. Si quedan recursos, empezar la siguiente prueba como si la limpieza hubiera funcionado esconde indicios útiles. Comprueba el estado inicial real antes de seguir.
Así desapareció una fuente recurrente de interferencias en esta configuración. Los fallos posteriores había que investigarlos igualmente.
El camino hasta casa
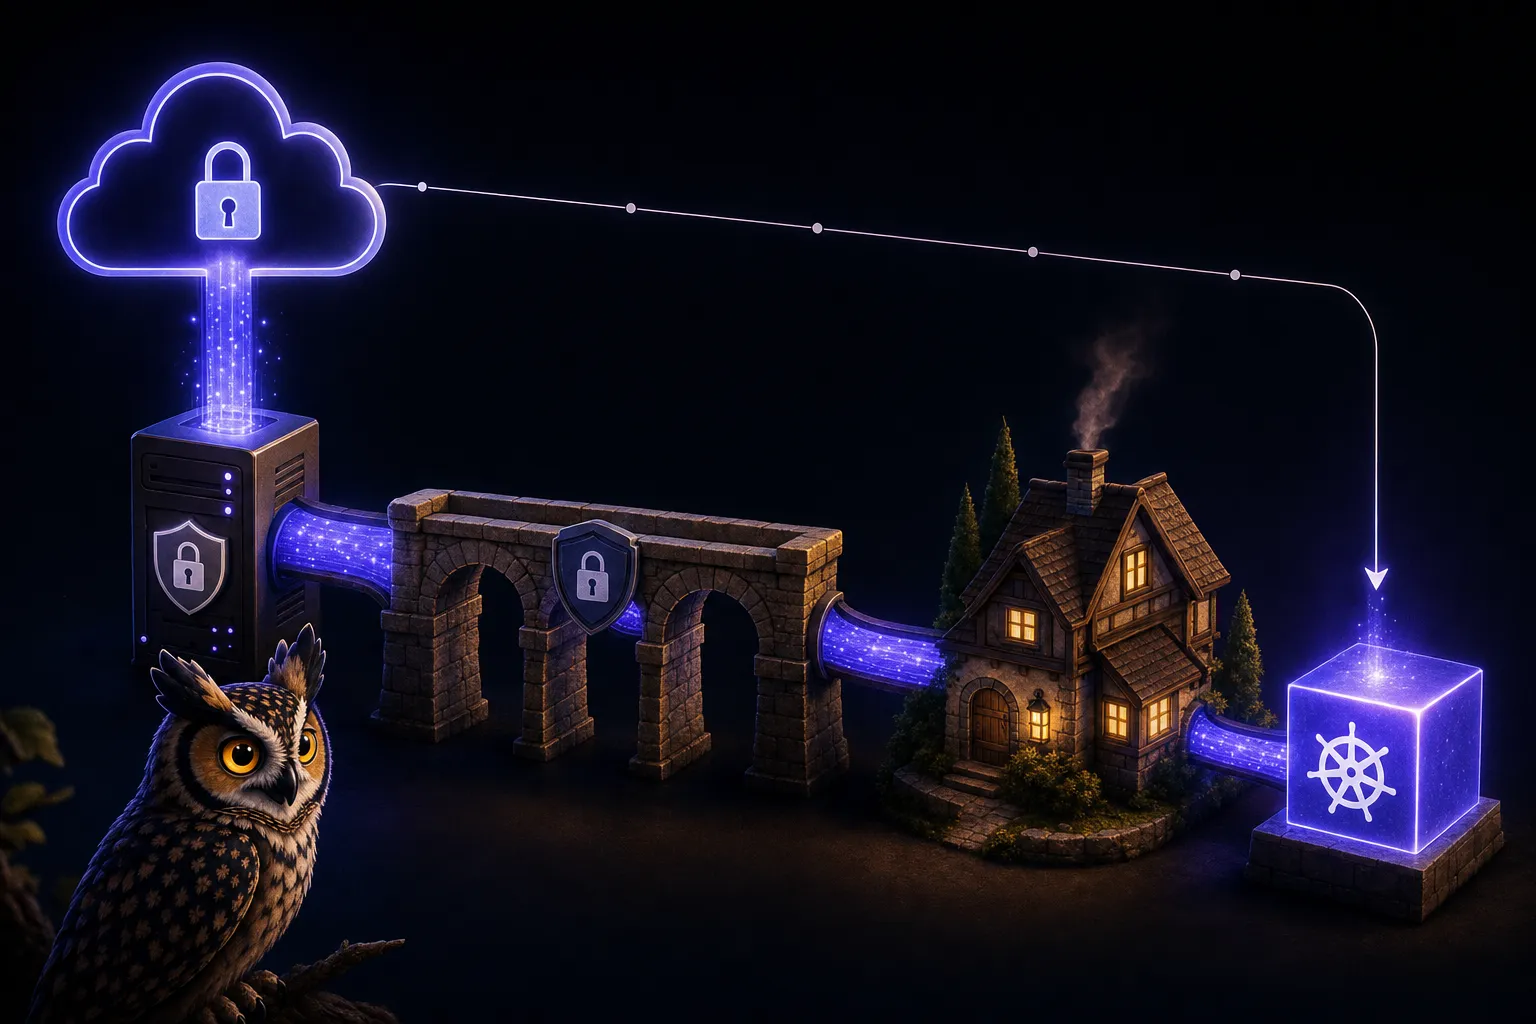
El clúster funcionaba en un servidor en casa, con una conexión a internet cuyo proveedor no daba una dirección pública utilizable para el tráfico entrante.
Nuestra ruta usaba una máquina virtual en la nube con una IP pública reservada, un proxy Nginx y WireGuard. El tráfico iba de Cloudflare al servidor intermedio, pasaba por el túnel cifrado hasta el servidor de casa y de ahí llegaba al servicio de Kubernetes.
Era nuestro montaje con servidor intermedio. No hay que confundirlo con usar el conector de Cloudflare Tunnel para todo el transporte.
La ruta se configuraba con Terraform, Ansible y scripts de shell. Un watchdog revisaba las reglas del cortafuegos cada sesenta segundos y corregía las desviaciones que reconocía. Podía recuperar reglas concretas. La red, aun así, podía fallar.
La dirección reservada estaba pensada para no cambiar con los desmontajes que describía la configuración. Había que seguir manteniendo el estado del proveedor, las credenciales y la configuración.
Ahora, un fallo de red debería darme un fallo de red que inspeccionar. Esperar más a un agente no puede reparar una ruta rota hacia su entorno.
Este trabajo hizo que la prueba fuera más fácil de diagnosticar. Podía distinguir un agente callado, un sandbox abandonado y un camino roto hacia el clúster, en lugar de darles a los tres otra hora.
El atajo de inicio de sesión, la biblioteca de aprovisionamiento, los permisos de limpieza, la contabilidad de tokens y la configuración de red siguen necesitando mantenimiento. Un cambio en cualquiera de ellos puede invalidar una suposición de la prueba.
Servicios OwlMeans puede incluir infraestructura de entrega y de pruebas como esta. El trabajo tiene que ajustarse al stack real y a sus modos de fallo; la configuración de junio no es una promesa de desplegar cualquier sistema en pocos días.
Cambié tiempo de espera por tiempo de mantenimiento del arnés. Para este flujo, valió la pena.
Publicado originalmente el 23 de junio de 2026. Revisado el 15 de octubre de 2026 para no mezclar el detector de actividad con las comprobaciones de que el resultado es correcto, y para matizar lo que se afirmaba sobre la infraestructura.