Unser schwierigster End-to-End-Test konnte 40 Minuten lang auf einen Agenten warten. Die erste Version gab ihm ein Timeout von 80 Minuten. Tat der Lauf nichts Nützliches mehr, wartete ich oft den größten Teil dieser Zeit, bevor ich es merkte.
Ich musste immer wieder an Dujiangyan denken. Die UNESCO beschreibt ein Bewässerungssystem, dessen Bau im 3. Jahrhundert v. Chr. begann und das den Fluss ohne Staudamm reguliert. Es ist bis heute in Betrieb und wird laufend instand gehalten.
Für genau eine Entscheidung in meinem Test war der Vergleich nützlich. Ich brauchte ein Signal aus dem laufenden Prozess und keine weitere Schätzung, wie lange er eigentlich dauern müsste.
Der Test steuert OwlMeans über den Browser. Er legt ein Nutzerkonto an, schickt einen Prompt ab, wartet auf eine Spezifikation und bestätigt sie. Für das Projekt startet eine neue Kubernetes-Sandbox. Dann entwickelt ein Agent die erste User Story. In den Läufen, auf denen dieser Artikel vom Juni beruht, dauerte der letzte Schritt zwischen 10 und 40 Minuten.
Hätte ich das Modell gemockt, hätte der Test eine andere Frage beantwortet. Hier wollte ich wissen, ob Browser, Pipeline und Projektumgebung den Ablauf gemeinsam bis zum Ende schaffen.
Für den Browser nutzt unser Testaufbau @owlmeans/test-ui als Schicht um Playwright. Der Test-Login läuft über unseren Supervisor-Mechanismus. Dass eine echte Anmeldung über Google funktioniert, belegt genau dieser Test also nicht.
Die Sandbox kommt aus @owlmeans/kephemeral. Das Paket legt den temporären Namespace an, dazu Speicher, Workload und Netzwerkrichtlinie. Außerdem überwacht es den Workload und kann einen abgestürzten Pod wiederherstellen.
Diese Wiederherstellung hilft, die Umgebung verfügbar zu halten. Ob die Antwort des Agenten stimmt, erfährt der Test dadurch nicht.
Die Warteschleife
Während der Agent arbeitet, verbraucht er Tokens. Änderungen am erfassten Token-Guthaben habe ich als Zeichen genommen, dass der Lauf noch aktiv war.
Der Test las dieses Guthaben alle 20 Sekunden ab. Solange es sich änderte, ließ der Detektor den Test weiter warten. Blieb es zehn Minuten lang unverändert, wertete er den Lauf als möglicherweise festgefahren und brach ihn mit einem Fehler ab.
Das war eine Liveness-Heuristik für unsere Pipeline. Ändert sich das Guthaben, kann das auch unproduktive Arbeit bedeuten. Bleibt es gleich, kann ebenso ein berechtigtes Warten dahinterstecken, eine verzögerte Abrechnung oder ein Problem außerhalb des Modells.
Assertions für den erwarteten Zustand der Story und für das Verhalten im Browser brauchte ich trotzdem. Verbrauchte Tokens erfüllen keine dieser Assertions.
Die Schwellenwerte waren Entscheidungen für den Ablauf vom Juni und keine Standardwerte, die ich einem anderen Team vorschreiben würde. Zeichne auf, was dein lang laufender Vorgang tatsächlich ausgibt, und entscheide dann, wie lange Stille sein darf, bevor du der Sache nachgehst.
Auch die Testempfehlungen von Playwright betonen, wie wichtig isolierte Tests sind. Unser langsames Warten war nur eine Quelle unzuverlässiger Läufe.
Die verwaiste Sandbox
Brichst du einen Test nach dem Provisionieren ab, bleibt unter Umständen ein Projekt zurück. Der nächste Lauf trifft dann auf eine Umgebung, die der Test so nie anlegen wollte.
Wir haben ein einziges Testprofil wiederverwendet. Vor und nach jedem Lauf hat der Testaufbau die Testprojekte dieses Profils gelöscht. Das Aufräumen vor dem Lauf war wichtig, weil der vorherige Prozess womöglich nie bis zu seinem Teardown gekommen war.
Was gelöscht wird, muss eng begrenzt bleiben. Eine Aufräumroutine, die an fremde Projekte herankommt, wäre ein viel größeres Problem als ein instabiler Test.
Melde Fehler beim Aufräumen. Bleiben Ressourcen übrig und startet der nächste Test, als hätte das Aufräumen geklappt, verschwinden nützliche Hinweise. Prüfe den tatsächlichen Ausgangszustand, bevor es weitergeht.
Damit war in diesem Setup eine wiederkehrende Störquelle beseitigt. Spätere Fehler mussten trotzdem untersucht werden.
Der Weg nach Hause
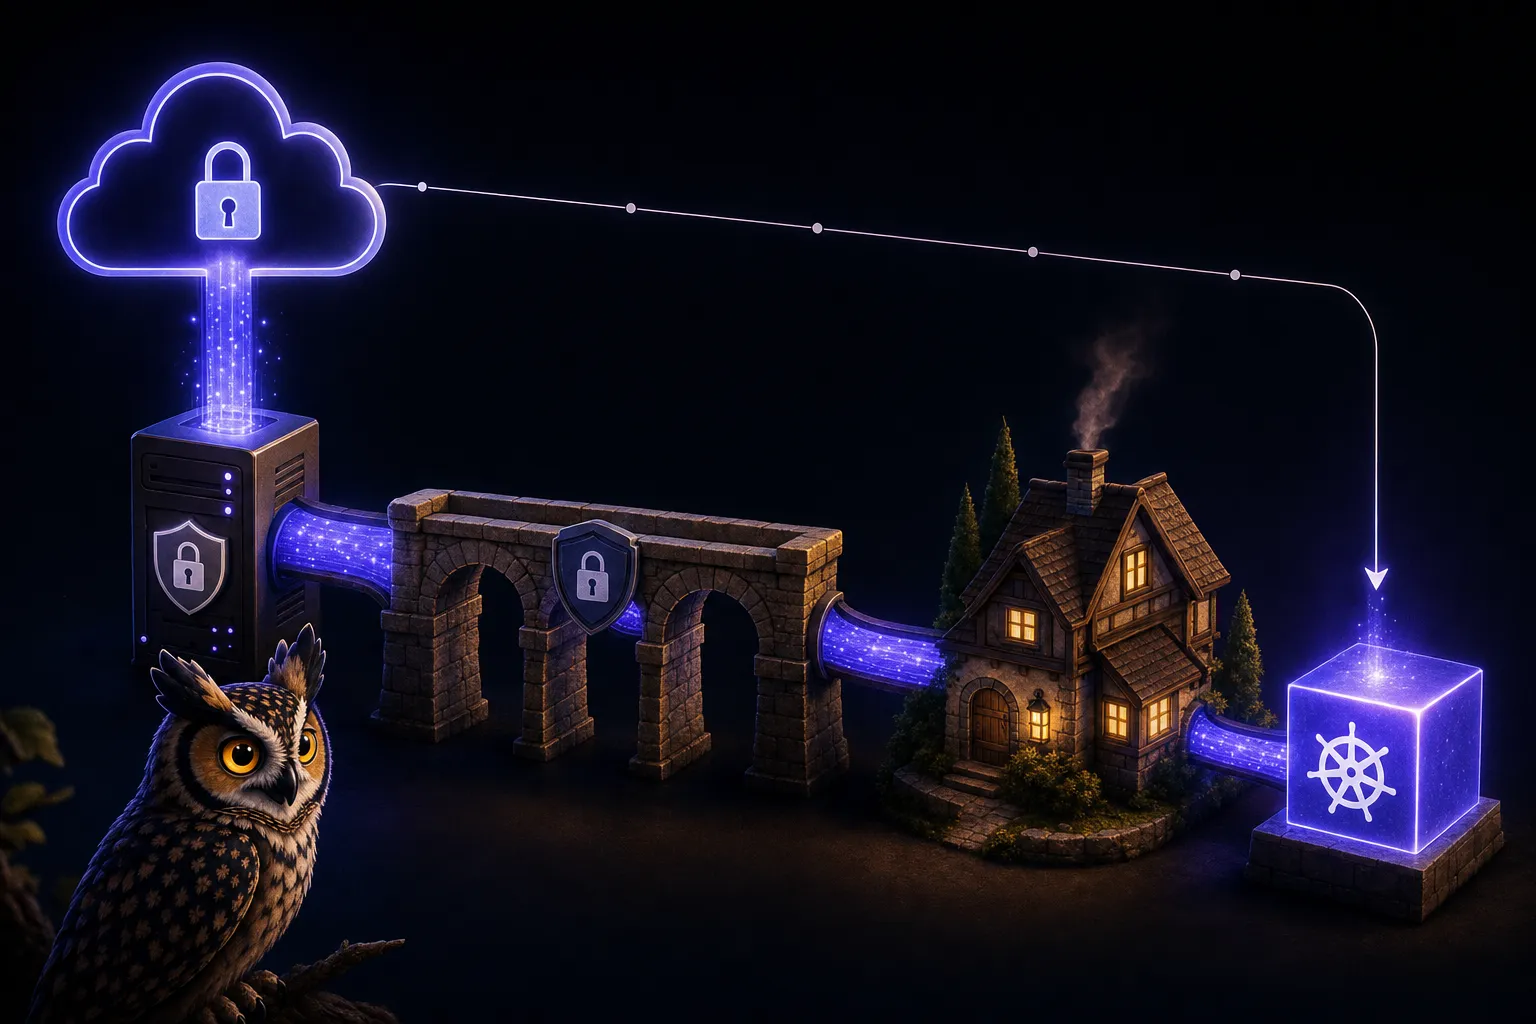
Der Cluster lief auf einem Server bei mir zu Hause, hinter einem Internetanschluss ohne nutzbare öffentliche Adresse für eingehende Verbindungen.
Unsere Route führte über eine Cloud-VM mit reservierter öffentlicher IP, einen Nginx-Proxy und WireGuard. Der Datenverkehr ging von Cloudflare zum Relay, durch den verschlüsselten Tunnel zum Server zu Hause und von dort zum Kubernetes-Service.
Das war unser Relay-Aufbau. Verwechseln sollte man ihn nicht mit der Variante, bei der der gesamte Transport über den Connector von Cloudflare Tunnel läuft.
Terraform, Ansible und Shell-Skripte haben die Route konfiguriert. Ein Watchdog prüfte alle 60 Sekunden die Firewall-Regeln und korrigierte die Abweichungen, die er erkannte. Bestimmte Regeln konnte er wiederherstellen. Ausfallen konnte das Netzwerk trotzdem.
Die reservierte Adresse sollte über die Teardowns hinweg stabil bleiben, die das Setup beschreibt. Der Zustand beim Anbieter, Zugangsdaten und Konfiguration mussten trotzdem gepflegt werden.
Fällt jetzt das Netzwerk aus, sollte ich auch einen Netzwerkfehler zu sehen bekommen, den ich untersuchen kann. Längeres Warten auf einen Agenten repariert keine kaputte Route zu seiner Umgebung.
Durch diese Arbeit lässt sich der Test leichter diagnostizieren. Einen stillen Agenten, eine verwaiste Sandbox und einen kaputten Weg in den Cluster konnte ich damit auseinanderhalten, statt allen dreien noch eine Stunde zu geben.
Die Abkürzung beim Login, die Bibliothek fürs Provisioning, die Berechtigungen fürs Aufräumen, die Token-Abrechnung und die Netzwerkkonfiguration brauchen weiterhin Pflege. Ändert sich eines davon, kann eine Annahme im Test hinfällig werden.
Zu den OwlMeans Services kann auch diese Art von Auslieferungs- und Testinfrastruktur gehören. Die Arbeit muss zum tatsächlichen Stack und zu dessen Fehlerarten passen. Das Setup vom Juni ist kein Versprechen, jedes beliebige System in ein paar Tagen zu deployen.
Ich habe Wartezeit gegen Zeit für die Pflege des Testaufbaus eingetauscht. Für diesen Ablauf hat sich das gelohnt.
Erstmals veröffentlicht am 23. Juni 2026. Am 15. Oktober 2026 überarbeitet: Der Liveness-Detektor ist jetzt klar von den Prüfungen auf Korrektheit getrennt, und die Aussagen zur Infrastruktur sind eingeschränkt.