On me demande sans arrêt quand on pourra utiliser OwlMeans. Jusqu’ici, la réponse honnête était : quand la plateforme sortira. J’en ai maintenant une meilleure : la partie qui compte le plus, tu peux l’utiliser dès aujourd’hui, avec l’agent auquel tu fais déjà confiance.
OwlMeans est un pipeline de développement par IA. Tu décris ce que tu veux sous forme de user stories, et une équipe de rôles IA spécialisés en fait des applications TypeScript full-stack qui t’appartiennent vraiment. Sous chacune de ces applications, on retrouve une seule bibliothèque, OwlMeans Common, celle sur laquelle reposent tous nos projets. Cette semaine, elle s’est dotée d’un paquet create-app. Une commande suffit pour générer un projet full-stack complet que Claude Code ou GitHub Copilot peut développer de bout en bout, consignes pour l’agent comprises.
Je vais te montrer ce que donne cette commande, pourquoi elle est construite ainsi et comment passer d’un dossier vide à une vraie fonctionnalité adossée à une base de données sans écrire toi-même la moindre ligne de harness.
La commande
Choisis ton gestionnaire de paquets :
bun create @owlmeans/app my-app
# ou
npm create @owlmeans/app@latest my-app
# ou
npx @owlmeans/create-app@^0.1.18-rc.62 my-app
Ensuite :
cd my-app
bun run dev          # API sur :3000, web sur :3001
Ouvre l’application web, va sur l’écran Session, ajoute quelques éléments puis supprime-les. Tu as sous les yeux une application full-stack qui tourne : un contrat partagé et typé, un backend et un frontend en shadcn UI qui se parlent. Pas de base de données à provisionner, pas d’authentification à configurer, pas de boilerplate recopié depuis un tutoriel.
Tu obtiens un petit monorepo avec trois workspaces :
common— le contrat partagé : les entrypoints des routes, les schémas de validation et les types utilisés des deux côtés.api— le backend, sur@owlmeans/server-app, qui garde les données de démo dans une ressource en mémoire.web— le frontend, sur@owlmeans/web-panel, avec une navigation shadcn, un layout et des écrans.
Cette structure n’a rien d’un jouet. C’est la forme de nos vraies applications, réduite à l’essentiel. Le jour où le stockage en mémoire ne suffit plus, tu changes un paquet, et je te montre plus bas exactement comment.
Pourquoi tout est fait pour que l’agent ne se perde pas
Voici la vérité qui dérange sur les agents de code en 2026 : ils n’ont aucune ancienneté dans la maison. Chaque session repart de zéro, et chaque appel paie le prix fort pour tout ce que ta base de code n’a pas rendu explicite. Les chiffres sont brutaux. Sur une base de code de taille moyenne, la phase d’exploration, celle où l’agent lit des fichiers juste pour comprendre où se trouvent les choses, peut engloutir « 60 à 70 % du total des tokens en entrée », et une seule tâche peut faire passer des centaines de milliers, voire des millions de tokens cumulés par le modèle. L’agent est intelligent. Mais il « part d’une page blanche, à part ce que tu places explicitement dans sa fenêtre de contexte ».
La question qui a façonné OwlMeans Common était donc simple : à quoi ressemble une base de code conçue pour être lue par quelque chose qui oublie tout d’une session à l’autre ?
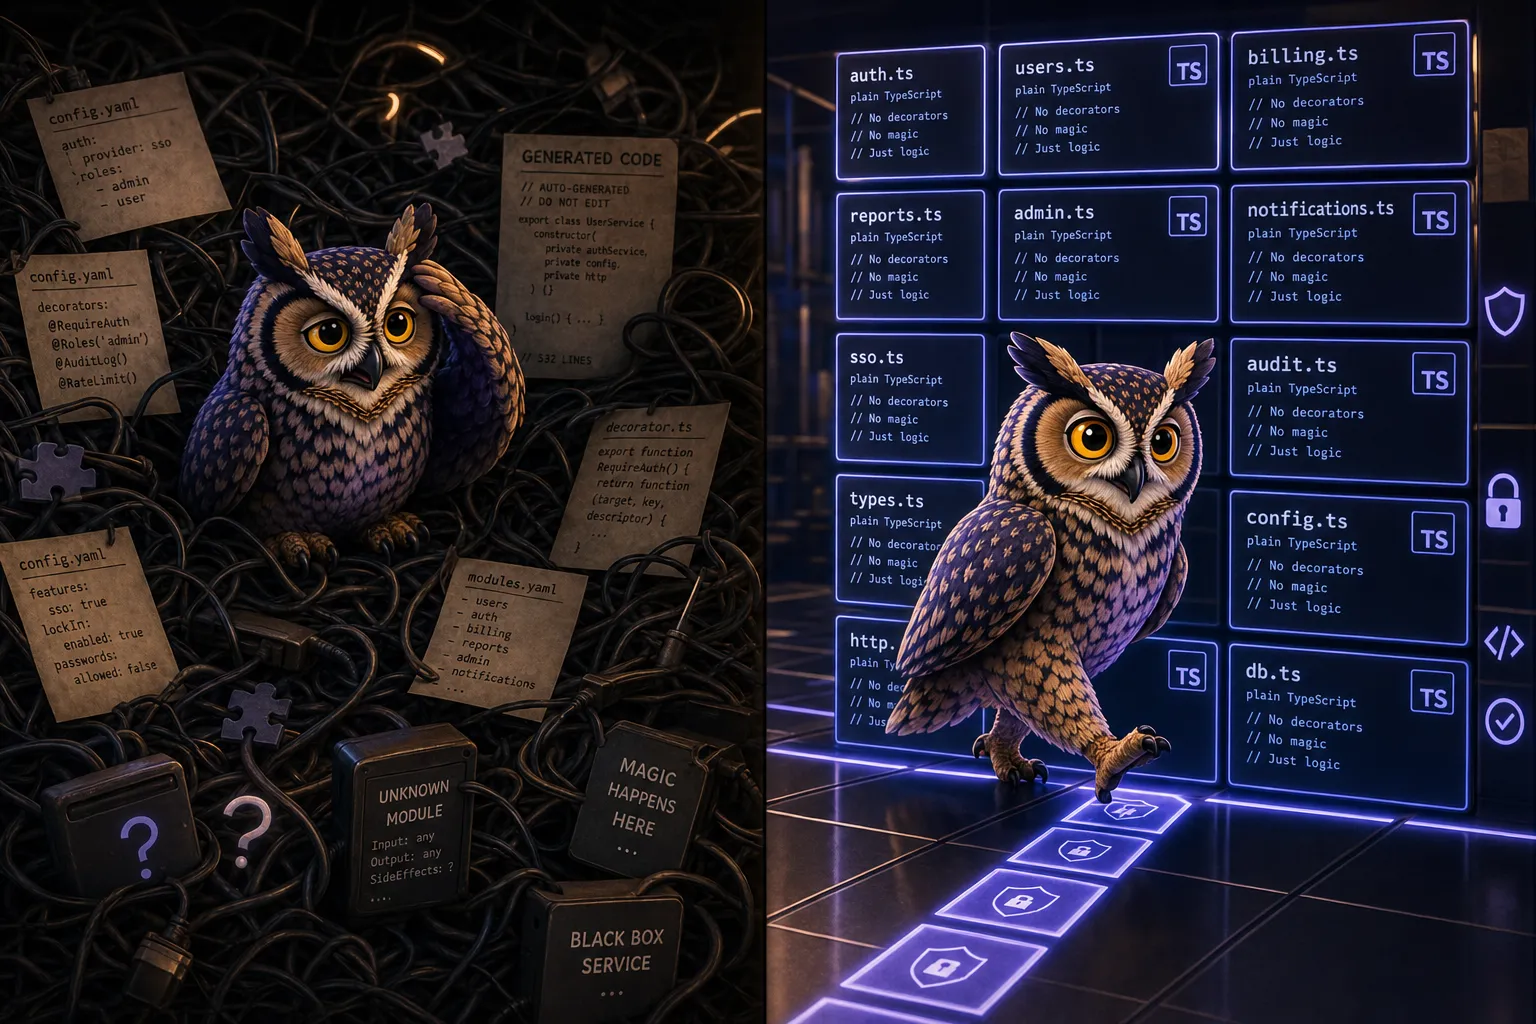
La réponse, c’est ce que les ingénieurs seniors ont toujours réclamé. Le secteur y est arrivé de son côté cette année : « le code doit être simple, explicite et ennuyeux […] pour que l’IA n’ait aucune décision à prendre », et les agents « peinent face aux comportements implicites et aux abstractions astucieuses ». C’est précisément la contrainte qu’on s’est imposée :
- Pas de schémas d’injection de dépendances compliqués. Les services sont de simples fonctions factory en TypeScript, enregistrées sous un alias textuel et récupérées avec
context.service('alias'). Pas de décorateurs, pas de métadonnées, pas de conteneur magique à décortiquer. - Pas de code généré. Pas d’étape qui transforme une spec OpenAPI en client, pas de génération de code à partir de schémas, aucun artefact de build à garder en phase avec la réalité. Ce que tu lis, c’est ce qui s’exécute.
- Pas de YAML, pas de configuration éparpillée. La configuration, c’est du TypeScript. Routes et configuration sont de simples objets.
- Tout est explicite et traçable. Chaque service, chaque route, chaque ressource se retrouve par une simple recherche. Un humain peut suivre le fil. Un agent aussi, sans brûler mille tokens à deviner.
Ce dernier point, c’est tout l’enjeu. Un code explicite et ennuyeux coûte moins cher à un agent, et c’est ce qui sépare l’assistant qui modifie sans hésiter le bon fichier de celui qui en retourne quarante.
Quatre idées qui simplifient le travail de l’agent
Quatre choix de conception font l’essentiel du travail. Inutile de les apprendre par cœur, mais ils méritent qu’on les regarde une fois : c’est grâce à eux que, quand tu demandes une fonctionnalité à Claude Code, le travail aboutit proprement au lieu de partir dans tous les sens.
L’injection de contexte. Le contexte de l’application contient les services et les ressources, et il se transmet de haut en bas. Tu enregistres un service sous forme de closure factory et tu le résous par son alias. Rien n’est caché : tout le câblage est du code ordinaire qu’un agent lit d’une traite.
Les entrypoints, protocole full-stack universel. Tout repose là-dessus. Un entrypoint est une unité d’URL (un alias, un chemin, une méthode et un schéma de validation écrit sur place), déclarée une seule fois dans common :
entrypoint(
  route(session.add, '/:sid/items', { parent: session.base, method: RouteMethod.POST }),
  filter(params(SessionParamsSchema), body(AddItemSchema)),
)
Côté backend, elevate greffe un handler sur ce même entrypoint. Côté frontend, elevate y greffe un écran, et on l’appelle avec ctx.entrypoint(session.add).call({ params, body }). Une seule déclaration fait foi pour la route, la validation et les types des deux côtés. Tu la modifies une fois, et toute la stack suit. Pas de spécification d’API à part, pas de client généré qui se désynchronise. Pour un agent, une nouvelle fonctionnalité a donc une forme évidente et toujours la même : déclarer, implémenter, appeler.
Des ressources unifiées. Chaque stockage de données (en mémoire, MongoDB, Redis, stockage objet) implémente la même interface Resource<T> : get, list, create, update, delete et quelques autres. Le code des handlers ne bouge pas quand le stockage change. Remplacer le stockage en mémoire de la démo par une vraie base de données revient, presque littéralement, à changer un paquet.
Une UI shadcn qui t’appartient. La couche web repose sur shadcn et Tailwind v4, et les composants vivent dans ton arborescence de code, pas derrière une dépendance. C’est voulu. shadcn « n’est pas une bibliothèque qu’on installe, c’est un générateur de code […] il t’appartient », et c’est devenu la bibliothèque de composants vers laquelle se tournent tous les outils de code IA. L’agent lit ton UI comme du vrai React modifiable, un code qu’il connaît déjà, au lieu de tâtonner dans un paquet opaque.
Toutes les skills dès le premier jour
C’est la partie dont je suis le plus fier. Le projet arrive en sachant déjà comment on le développe.
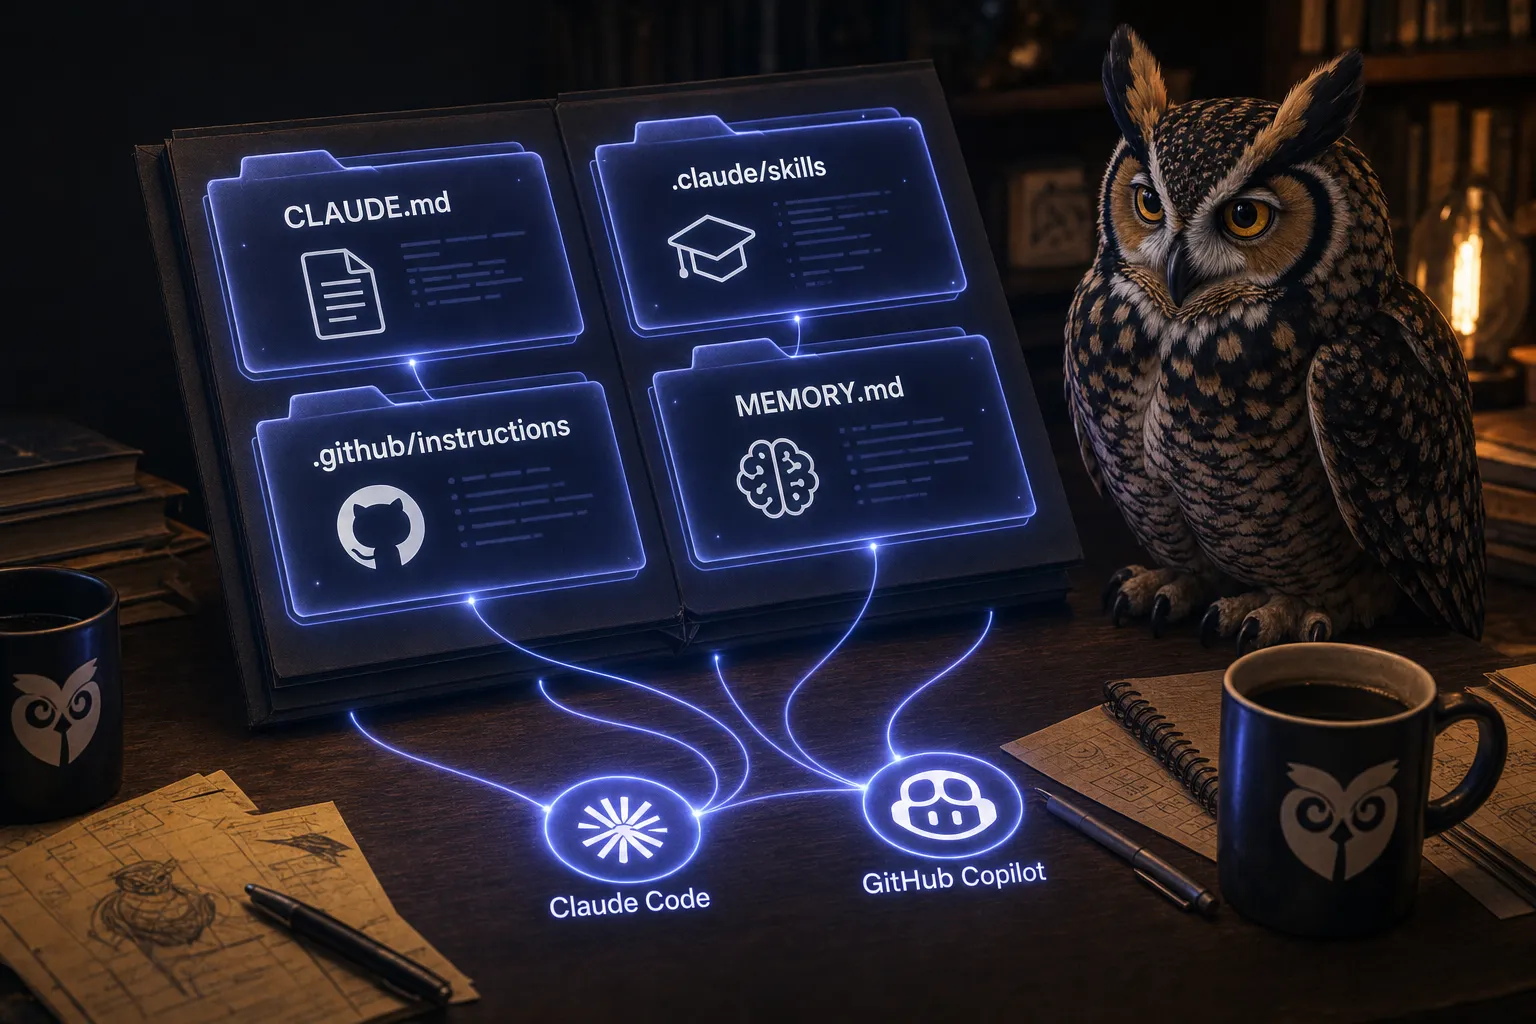
Chaque paquet @owlmeans/* embarque ses propres consignes pour les agents : des skills pour Claude Code et des instructions pour GitHub Copilot, alignées sur la version du paquet. Quand create-app a fini de générer le projet, il y déploie ces consignes : les skills atterrissent dans .claude/skills/, les instructions dans .github/instructions/. Il écrit aussi un CLAUDE.md et un .github/copilot-instructions.md avec des directives de mémoire, ainsi que des index de mémoire initiaux que les deux agents lisent au début de chaque session.
Du coup, quand tu ouvres le projet et que tu demandes à Claude Code de toucher à la couche des ressources, il n’a pas besoin de découvrir comment fonctionnent les ressources OwlMeans : la skill mongo-resource est déjà là. Quand il ajoute une route, la skill entrypoint l’attend aussi. Il y a même une règle reuse-code, inscrite dans CLAUDE.md, qui demande à l’agent de chercher un paquet @owlmeans/* existant avant d’écrire quoi que ce soit sur mesure. La première fois que tu l’ouvres, l’agent te demande à quoi sert le projet et note ta réponse dans les deux fichiers de contexte, pour ne plus jamais avoir à te poser la question.
Tout ça, ce n’est pas toi qui l’as écrit. Tu n’as câblé aucun harness. Les skills, la mémoire et les conventions sont arrivées avec la commande. Voilà ce que veut dire, concrètement, « autonome et doté de toutes ses skills », et c’est la même mécanique que celle sur laquelle s’appuie notre plateforme, remise directement entre tes mains.
Pas à pas : du squelette à une vraie fonctionnalité
Prenons un cas concret. Disons que tu veux transformer le stockage en mémoire de la démo en une vraie fonctionnalité persistante, adossée à MongoDB. Tu n’ouvres pas la doc pour te mettre à brancher des drivers. Tu génères le projet, puis tu demandes.
D’abord, génère le projet et lance-le (les deux gestionnaires conviennent) :
bun create @owlmeans/app my-app     # ou : npm create @owlmeans/app@latest my-app
cd my-app
bun run dev
Ensuite, dans Claude Code (ou Copilot), pars d’un prompt comme celui-ci :
Ajoute une fonctionnalité notes persistante, adossée à MongoDB. Utilise
@owlmeans/mongoet@owlmeans/mongo-resourceà la place de la ressource statique en mémoire. Déclare les entrypoints et le schéma danssources/common, enregistre la ressource et implémente les handlers danssources/api, puis ajoute un écran danssources/web. Réutilise les paquets@owlmeans/*existants en suivant la skillreuse-code.
Ce prompt marche sans qu’on ait à tenir la main de l’agent, et ça vaut la peine de comprendre pourquoi. Le projet contient déjà les skills prévues précisément pour ce cas. L’agent sait que la ressource se remplace terme à terme, puisque toutes les ressources implémentent la même interface : le handler qui faisait context.getStaticResource(...) passe à context.resource(...) sur une collection Mongo, et les appels create/list/delete restent identiques :
const notes = context.resource<NotesResource>(RES_NOTES)
await notes.create({ id, text, createdAt })
const { items } = await notes.list({ criteria: { ... } })
Il sait que la mécanique des entrypoints ne change pas : on déclare dans common, puis elevate y attache un handler dans api et un écran dans web. Et il sait que ton UI est du shadcn qu’il peut modifier directement. Comme la structure est explicite et que le dépôt embarque les consignes, l’agent dépense ses tokens à construire ta fonctionnalité au lieu de réapprendre le framework à chaque session. Quand tu mettras à jour les paquets @owlmeans/*, il te suffira de relancer npx @owlmeans/agent-skills@^0.1.18-rc.53 pour que les consignes suivent.
Pourquoi ce n’est qu’un début
Je vais être franc sur ce que c’est, et sur ce que ce n’est pas.
create-app, c’est la bibliothèque et les consignes pour agents, qu’on te confie pour que tu les pilotes toi-même avec Claude Code ou Copilot. C’est réellement puissant, et pour beaucoup de projets, ça suffit. OwlMeans Platform, le pipeline complet de rôles IA spécialisés qui transforme des user stories en logiciels finis qui t’appartiennent, est la couche du dessus. Et on l’a construite autour de cette même bibliothèque. C’est précisément ce qui lui permet de faire ce qu’elle fait pour une fraction du coût. Au lieu d’explorer une base de code inconnue à chaque session et de payer la taxe d’exploration, elle travaille sur un framework conçu dès le départ pour rester explicite et prévisible, donc peu coûteux à analyser. Notre objectif : que la plateforme construise ces projets avec environ dix fois moins de tokens qu’un agent de code livré à lui-même, qui s’échine sur un dépôt qu’il ne connaît pas.
Mais tu n’as pas besoin d’attendre. Les fondations sur lesquelles repose la plateforme sont disponibles dès aujourd’hui, en une commande, sur l’agent que tu paies déjà. Lance create-app, mets Claude Code dessus, et tu auras un vrai avant-goût de la façon dont OwlMeans construit : du code typé et explicite, équipé de toutes ses skills, qui reste à toi.
C’est l’idée de l’équipe autour de l’agent, réduite pour tenir dès maintenant dans ton terminal.