Pendant un mois environ, j’ai essayé d’obtenir avec des modèles open-weight ce que nous donnent nos modèles propriétaires.
Pas dans toute l’entreprise, seulement dans la salle des machines. OwlMeans est un pipeline de développement IA : vous décrivez ce que vous voulez sous forme de user stories, et une équipe de rôles IA spécialisés en tire une application full-stack qui vous appartient. En coulisses, chacun de ces rôles appelle un modèle de langage. Aujourd’hui, c’est une combinaison de modèles Anthropic et OpenAI : Claude abat l’essentiel du travail, OpenAI intervient sur certains rôles précis. J’ai confiance dans cette configuration. Elle a aussi un prix.
J’ai donc fait l’expérience qui s’imposait. L’année a été fracassante pour les modèles open-weight : dès la mi-2025, les meilleurs LLM open-weight venaient de Chine, et GLM, Kimi, Qwen et DeepSeek rendaient coup pour coup aux meilleurs modèles propriétaires en programmation. Et pour une fraction du prix. Si je pouvais faire tourner mon pipeline sur de l’open-weight sans dégrader le résultat, le calcul devenait irrésistible.
J’ai passé le mois à les brancher, à les mesurer et à les régler. Voici ce qui s’est réellement passé, y compris ce que je n’avais pas vu venir et qui, au bout du compte, était l’essentiel.
Le pari : le pipeline devait rendre le modèle interchangeable
Voici ce qui me faisait croire que ça pouvait marcher.
OwlMeans ne tend pas un prompt vague à un modèle en croisant les doigts. Il découpe un projet en tâches minuscules, au périmètre serré, qui tournent chacune avec très peu de contexte : une seule user story, un seul correctif, les modifications d’un seul fichier. Un rôle d’analyste métier cadre le travail, un architecte le conçoit, un rôle de développeur en implémente une tranche, un correcteur fait le ménage. Personne ne demande à un modèle de « construire l’appli ». On lui demande une seule petite chose, bien spécifiée.
Cette conception a un effet de bord discret : plus la tâche est petite et précise, moins le choix du modèle compte. Avec un contexte minuscule et une consigne exacte, presque n’importe quel modèle compétent arrive à peu près au même endroit. Il y a moins de place pour briller, et moins pour s’égarer. C’est aussi pour ça que nos coûts en tokens restent raisonnables. Les études sur les boucles d’agents le disent sans détour : le coût en tokens croît avec le carré du contexte qu’on refacture à chaque étape ; garder chaque tâche petite, c’est ce qui sépare une facture tenable d’une facture qui s’emballe.
Mon hypothèse était donc simple : si le pipeline banalise déjà la tâche, il devrait aussi banaliser le modèle. Si l’on remplace un modèle propriétaire par GLM, l’application qui sort à l’autre bout devrait être, pour l’essentiel, la même.
Là-dessus, j’avais à peu près raison. Sauf que ça n’a pas joué comme je l’espérais.
Ce qui a cassé en premier : les modèles qui réfléchissent trop
Le passage à l’open-weight ne s’est pas fait en douceur.
Le premier mur, ce sont les modèles « qui réfléchissent ». GLM, Kimi, Qwen raisonnent par défaut. Sur le papier, c’est très bien. En pratique, dès qu’on plafonne la sortie, le modèle épuise tout son budget à raisonner en silence, puis ne renvoie rien. Un contenu vide. Le rôle de codeur se déclenchait, le modèle réfléchissait jusqu’au plafond de tokens et rendait une chaîne vide. Le pipeline s’étranglait sur une non-réponse.
J’ai mis effort: none. Le modèle l’a ignoré sans un mot et a continué à réfléchir.
Je ne suis pas le seul dans ce cas : c’est le secret honteux des modèles de raisonnement en production. Comme le résume très bien un article, l’effort de raisonnement est un curseur de coût, pas un curseur de qualité. Poussez-le à fond : les tokens de réflexion peuvent tripler pour quelques points de benchmark gagnés, avec en prime des factures surprises et des sorties vides quand le raisonnement occupe la place réservée à la réponse. Le remède n’a rien de glorieux : un plafond absolu sur les tokens de raisonnement, rôle par rôle, réglé modèle par modèle, pour que la réflexion ne puisse plus affamer la sortie. On tient les codeurs en laisse courte ; on laisse plus de mou aux rôles de planification. Il n’existe pas de réglage universel. Chaque modèle voulait le sien.
Le deuxième mur, c’est la sortie structurée. Mon pipeline compte sur des modèles qui renvoient du JSON propre, conforme au schéma, pour que l’étape suivante puisse s’en servir. Les API propriétaires font désormais ça très bien : avec le mode strict de sortie structurée d’OpenAI, les erreurs de format tombent sous les 0,1 %. Beaucoup de modèles open-weight, chez beaucoup de fournisseurs, n’en sont pas là. Ils renvoient du JSON malformé dans une part non négligeable des réponses, surtout quand la sortie est longue et le schéma imbriqué. J’ai donc arrêté d’imposer du JSON aux modèles fragiles pour les laisser passer par des appels d’outils, et j’ai réécrit la gestion du code source : l’agent ne prélève plus que les passages utiles et applique des diffs au lieu de réécrire des fichiers entiers. Moins de contexte, moins d’occasions de casser le format. Ce seul changement a davantage amélioré la fiabilité de l’open-weight que n’importe quel changement de modèle.
Le troisième mur, ce sont les fournisseurs eux-mêmes. Un même modèle ouvert se comporte différemment selon qui l’héberge : la vitesse, la fiabilité, et même le simple fait que la sortie structurée marche ou non. J’en ai testé toute une série. Certains étaient excellents. D’autres échouaient à la validation du schéma à chaque appel. D’autres encore tronquaient les réponses. Quelques-uns n’arrivaient tout simplement pas à servir les modèles dont j’avais besoin. J’ai fini par tout faire passer par OpenRouter, qui répartit chaque modèle sur seize à vingt fournisseurs sous-jacents, parfois plus, et bascule de l’un à l’autre en cas de panne. Pour regagner de la vitesse, je me suis appuyé sur sa variante :nitro, qui classe les fournisseurs par débit brut. Au bout du compte, je pouvais basculer tout le pipeline d’un preset open-weight à un preset propriétaire avec un seul flag, et faire passer exactement le même projet par les deux.
C’est cet interrupteur qui m’a enfin permis de les comparer honnêtement. Et c’est dans la comparaison que les choses sont devenues intéressantes.
La surprise : le résultat était quasiment le même
Je m’attendais à ce que les modèles ouverts produisent du code visiblement moins bon. Ça n’a pas été le cas.
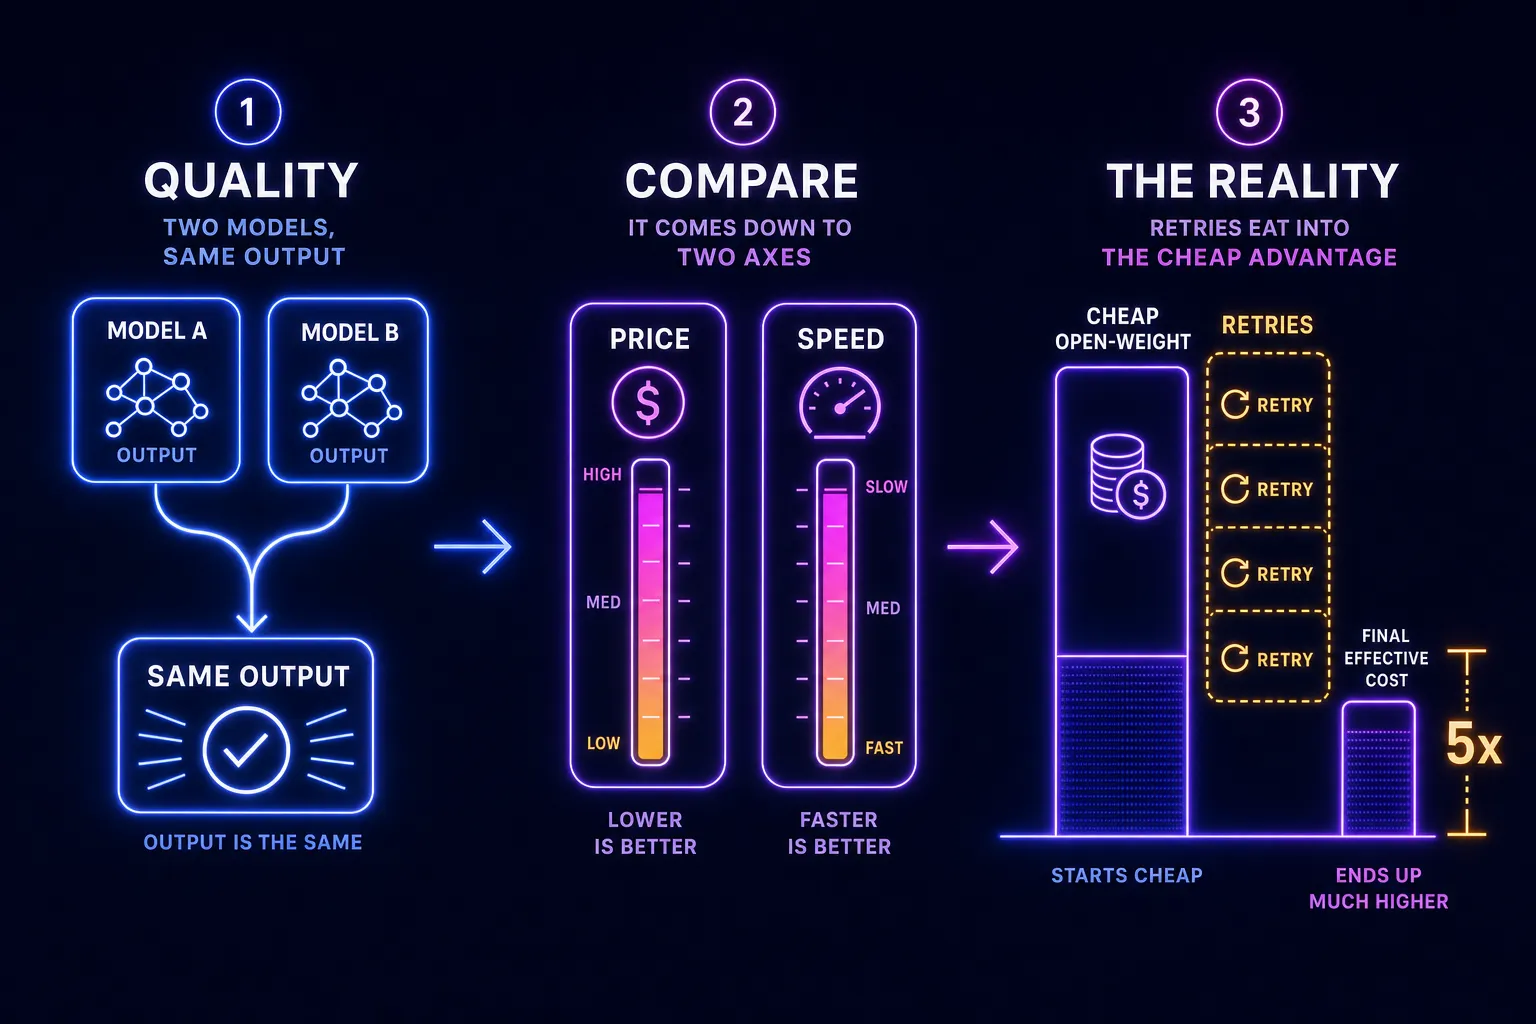
Comme le pipeline découpe tout en toutes petites tâches, le résultat final était presque identique d’un modèle à l’autre. Même structure, même comportement, même application. Les écarts étaient minimes et presque esthétiques : surtout la qualité du CSS, et de temps en temps une fioriture. Et voici ce que je trouve franchement drôle : les pires coupables étaient les modèles les plus avancés. Donnez une petite tâche précise à un modèle de pointe et il se met à créer. Il ajoute à l’interface un détail que personne n’a demandé, il décide que votre formulaire avait besoin d’une animation. Haiku, lui, fait ce qu’on lui demande, point. Plus le modèle est intelligent, plus il a tendance à improviser, précisément là où l’improvisation est la dernière chose qu’on veut.
La question de la qualité, celle sur laquelle tout le monde s’écharpe dans les classements de benchmarks, s’est donc en grande partie évaporée. Il me restait deux axes, et deux seulement : le prix et la vitesse.
Et à mon sens, c’est là que tout le secteur devrait atterrir, s’il est honnête. Les analystes indépendants classent déjà les modèles exactement selon ces critères, avec l’intelligence, la vitesse et le prix dans trois colonnes distinctes, parce qu’une fois l’intelligence « suffisante » pour la tâche, c’est avec la vitesse et le prix qu’on vit au quotidien.
Là où les modèles bon marché cessent de l’être
Sur le papier, l’open-weight écrase la concurrence sur le prix. Le token open-weight coûte une fraction de celui du preset Anthropic et OpenAI. C’est toute la raison d’être de l’exercice.
Mais le prix au token est un piège, et j’ai foncé droit dedans.
Côté propriétaire, ce sont les modèles Anthropic qui portent l’essentiel de la charge. Sonnet et Haiku font moins d’erreurs, et leur inférence est plus rapide que ce que j’obtiens via OpenRouter, même avec Nitro. Requête par requête, l’écart de vitesse n’a rien de spectaculaire. Mais il s’additionne. Et le vrai impôt, ce sont les erreurs : avec le preset open-weight, l’agent doit s’arrêter pour corriger plus souvent. Un JSON défectueux ici, un diff confus là, une relance, une nouvelle planification. Chaque fois, ce sont des tokens en plus et du temps réel en plus.
Voilà le calcul qu’aucune page de tarifs n’affiche. Un modèle cinq fois moins cher au token, mais qui doit recommencer, n’est pas cinq fois moins cher en pratique : un taux d’échec de 20 % par étape double à peu près la facture de tokens, et dans une boucle d’agent ces échecs se cumulent d’une étape à l’autre. Tout le secteur réapprend en silence que des tokens moins chers ont donné des factures plus lourdes, car les relances dévorent les économies.
C’est exactement ce que j’ai vu se produire. La boucle arrêt-correction a englouti l’avantage de prix affiché au compteur. Et une fois tout additionné (l’inférence plus lente, les relances supplémentaires, les nouvelles planifications), l’écart réel entre mon preset propriétaire et mon preset open-weight tournait autour d’un facteur 5. Pas sur un benchmark. Sur le vrai travail, de bout en bout.
Soyons clairs sur ce que je n’affirme pas : je ne dis pas que l’open-weight est mauvais. Je parle de l’open-weight dans mon pipeline, aujourd’hui, chez les fournisseurs que j’ai testés, avec les réglages faits jusqu’ici. Ce qui m’amène à la partie dont je suis le moins sûr.
Pourquoi je ne me fie pas encore à mes propres chiffres
Un aveu un peu gênant. J’ai un chiffre, ce facteur 5, et je ne m’y fie pas complètement. Et vous ne devriez pas vous y fier non plus. Il n’est pas forcément faux ; c’est la manière dont on mesure d’habitude ces choses-là qui me pose problème.
L’ère des benchmarks se fissure au vu de tous. Les benchmarks de code de référence sont saturés et contaminés ; le secteur a passé 2025 à regarder les scores cesser de refléter les capacités réelles. Et le raccourci paresseux vers lequel tout le monde se tourne, faire noter le résultat par un modèle puissant, n’est pas plus fiable : un LLM utilisé comme juge présente une forte variance, sensible à l’ordre de présentation, sur les tâches de code. Demander à un modèle de pointe si le code d’un autre modèle est bon, ça ne prouve rien. C’est une impression assortie d’un intervalle de confiance.
Ma prochaine étape ne sera donc pas un nouveau benchmark. Je vais regarder le code que ces modèles ont réellement vibe-codé, de mes propres yeux et avec de vraies métriques : est-ce qu’il compile, est-ce que les tests passent, est-ce qu’il est maintenable, est-ce que j’aurais envie d’en être propriétaire. Il est tout à fait possible que GLM et Kimi donnent au final de meilleurs résultats quand je juge le vrai livrable plutôt qu’un score synthétique. Il se peut aussi que les modèles ouverts ne soient simplement pas encore bien réglés : les budgets de raisonnement et la dizaine de petits paramètres demandent presque certainement un ajustement modèle par modèle, et je n’ai fait qu’effleurer le sujet. Ce que j’attends, honnêtement : dès qu’on quitte les benchmarks synthétiques pour comparer de vrais résultats, le tableau devient plus flou, pas plus net.
Je vais continuer à creuser. Mais ce mois m’a déjà appris ce qui compte vraiment, et ce n’est pas un modèle.
Une leçon qui vaut plus que le résultat
Oubliez le classement une seconde.
Regardez ce qui a rendu l’open-weight utilisable dans mon pipeline : des plafonds de raisonnement propres à chaque modèle pour que la réflexion n’affame pas la sortie, le repli sur les appels d’outils quand le JSON flanche, l’extraction de passages et les diffs qui réduisent le contexte, la bascule entre fournisseurs et le routage au débit, l’attribution des modèles rôle par rôle. Rien de tout cela n’est le modèle. C’est la structure autour du modèle : un mois d’ingénierie sans gloire, qui sépare « les tokens bon marché existent » de « vous avez livré un logiciel qui fonctionne ».
Au fond, tout le produit est là. Un agent de code reste un agent de code, pas une équipe de développement logiciel. Le modèle est une matière première : vous pouvez en changer demain, et après ce mois-ci je peux vous dire précisément ce que ce changement vous rapporte. La valeur n’a jamais été dans le modèle. Elle est dans le pipeline qui fait produire à n’importe quel modèle du code que vous pouvez posséder et maintenir, et qui encaisse les relances, les erreurs de format et les réglages par modèle pour que vous ne les payiez pas de vos week-ends.
C’est la promesse qu’OwlMeans fait à ses clients, et je viens de passer un mois à me la démontrer de l’intérieur : OwlMeans, c’est l’équipe autour de l’agent. Vous décrivez votre produit en user stories. Le pipeline le découpe, l’exécute, le corrige, et vous remet un monorepo typé qui vous appartient, du code que vous continuez à faire évoluer avec l’agent de votre choix. Le coût est prévisible par story, et c’est le pipeline qui le rend prévisible.
Ce mois-là, vous pouvez vous l’épargner
Alors voici l’argumentaire honnête, présenté comme j’aimerais qu’on me le présente.
Si vous vibe-codez un vrai produit, vous tomberez exactement sur cette question : quel modèle, quel fournisseur, comment contenir la facture sans que le résultat parte en morceaux. Vous pouvez faire comme moi. Passer des semaines à câbler des presets, découvrir que effort: none est un mensonge, regarder vos tokens bon marché s’évaporer en relances, et apprendre modèle par modèle ce qui tient vraiment. Pour moi, ça en valait la peine, parce que construire ce moteur, c’est mon travail.
Ce n’est pas le vôtre.
Vous pouvez confier tout ça au pipeline qui a déjà mené ce combat : il fait les arbitrages économiques entre modèles, absorbe les relances, impose la structure et vous rend du code maintenable, qui vous appartient, avec un coût prévisible par story. Voilà l’offre. J’ai brûlé un mois et beaucoup de tokens pour trouver ce facteur 5. Vous, vous pouvez simplement prendre le pipeline.
Si votre problème, c’est de gagner du temps et des tokens en vibe-coding, voici le mois de R&D le moins cher de votre vie : celui que vous n’aurez jamais à faire.
OwlMeans est un pipeline de développement IA : décrivez ce que vous voulez sous forme de user stories et obtenez des applications full-stack, des chatbots, des agents IA et des pipelines de données typés, prêts pour le SSO, que vous continuez à faire évoluer avec l’agent de votre choix. Découvrez ce qu’il sait faire →