Pendant deux mois, je n’ai pas livré une seule fonctionnalité de mon produit.
OwlMeans est un pipeline de développement IA : tu décris ce que tu veux sous forme de user stories, et une équipe de rôles IA spécialisés en fait des applications full-stack qui t’appartiennent vraiment. C’est ça que je suis censé construire. Et de la mi-avril à la mi-juin, je n’y ai presque pas touché.
Je n’étais pas bloqué, et je ne changeais pas de cap non plus. Ce détour, je l’ai fait exprès, pour construire d’abord autre chose : un système d’exploitation agentique pour l’entreprise elle-même. Un seul endroit d’où je pilote le développement, la stratégie et le marketing, c’est-à-dire ce que je fais de toute façon chaque semaine. Les agents y font le gros du travail, et il ne me reste presque rien à gérer.
Je ne regrette aucun de ces jours. Voici ce que j’ai construit, pourquoi je l’ai fait et pourquoi, à mon avis, la structure compte bien plus que l’outil sur lequel tu la fais tourner.
Pourquoi j’ai lâché le produit
C’est là que ça devient inconfortable. Je construis une entreprise dont toute la promesse tient en une phrase : sors du chaos que le code généré par IA laisse derrière lui, et possède un logiciel que tu peux vraiment maintenir. Et pendant ce temps, je faisais tourner l’entreprise elle-même comme un tas de scripts bricolés à l’instinct, sans aucun lien entre eux.
La stratégie vivait à un endroit. Les notes sur la marque, à un autre. Le site web, à un troisième. Chaque texte marketing repartait de zéro, parce que rien ne gardait la trace de ce qu’on avait déjà décidé. Chaque conversation avec un assistant IA démarrait à froid : je réexpliquais qui on est, ce qu’on vend, ce qu’on ne dit pas en public, ce qui avait changé le mois précédent. L’agent était intelligent. Et il oubliait tout dès que je fermais la fenêtre.
Voilà le sale petit secret de quiconque travaille aujourd’hui avec des agents de code, et les recherches le confirment sans détour : des outils comme Claude Code n’ont pas de vraie mémoire persistante. La continuité n’existe que si tu la construis toi-même à partir d’une « documentation structurée, pas de la mémoire interne du modèle ». Le modèle le plus intelligent du monde se réveille quand même amnésique à chaque session.
Le problème que je devais régler pour l’entreprise était donc celui que je règle pour mes clients dans le produit : transformer un générateur brillant mais distrait en quelque chose qui a une structure, une mémoire et de la discipline. J’ai décidé de le régler d’abord pour moi. Si ça marchait, je comprendrais mieux mon propre produit. Sinon, autant l’apprendre à mes dépens plutôt qu’à ceux d’un client.
Ce que j’ai vraiment construit
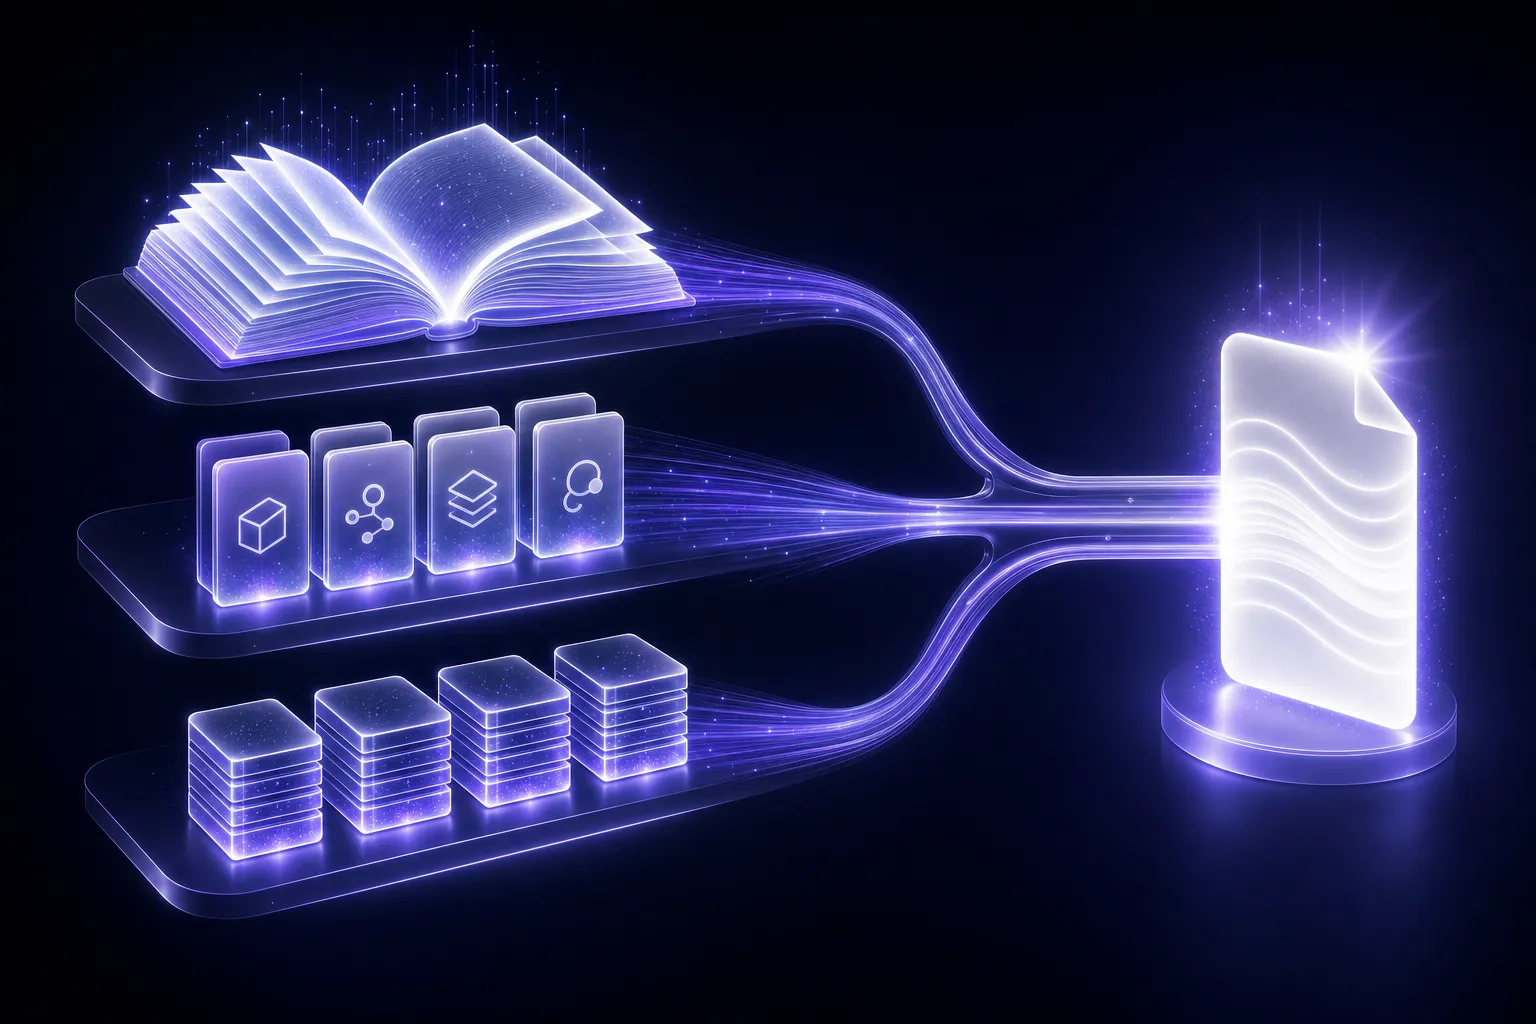
Ce que j’ai construit tient dans un dossier, sans app ni écran de connexion : une structure de simples fichiers Markdown que n’importe quel agent un peu capable sait lire et exploiter. Elle se compose de trois couches.
Un wiki qui fait boule de neige. Tout ce qu’il faut savoir sur l’entreprise tient dans du Markdown versionné : la stratégie, la voix de la marque, les règles de nommage, les personas clients, le juridique, le positionnement produit. Quand j’apprends quelque chose, je l’écris une fois. La prochaine fois qu’un agent travaille sur quoi que ce soit, ce savoir est déjà sur la table. Rien n’est à reconstruire de zéro. Le wiki devient plus malin chaque semaine sans que je l’entretienne comme une corvée : il grossit tout seul, à mesure que le travail avance.
Des skills qui apprennent à l’agent comment je travaille. Une skill, c’est juste un fichier Markdown qui décrit un processus répétable : comment faire les recherches et rédiger un article, comment garder le site et le wiki synchronisés, comment mettre à jour les documents juridiques, comment mener une recherche exhaustive. J’en ai vingt-six aujourd’hui. Elles apprennent toutes seules, au sens qui compte vraiment : quand je corrige l’agent, la correction retourne dans la skill ou dans la mémoire, et l’erreur ne revient pas. C’est exactement ce que le secteur a compris cette année : « le context engineering, c’est l’essentiel », autrement dit structurer l’information autour du prompt au lieu de peaufiner le prompt lui-même.
Tous les projets, reliés. Plus de vingt de nos dépôts de code sont rattachés à l’espace de travail, dont OwlMeans Common, le socle TypeScript partagé et la structure de projet sur lesquels s’appuient nos agents de code. La même discipline va donc d’une note de stratégie jusqu’au code source. Je peux pointer l’agent vers n’importe quel dépôt, lui demander ce qui a changé entre deux dates et obtenir un résumé écrit, ou transformer directement ce résumé en article sur la nouvelle version.
Par-dessus ces trois couches tourne un pipeline. J’y glisse une idée ; l’agent fait les recherches sur des sources à jour, rédige le texte dans notre ton, génère les images et, quand je lui donne le feu vert, le publie sur le blog, qui n’est lui-même qu’une partie du code source du site. L’article que tu lis est passé par ce pipeline. J’ai dicté l’idée en quelques phrases. Tout le reste, y compris les liens de recherche plus haut, c’est l’agent qui l’a assemblé.
Comment font les autres, et pourquoi j’ai pris un autre chemin
Je ne suis pas le seul à essayer de faire tourner une entreprise sur des agents IA. Mais presque tout le monde s’y prend de trois façons, et toutes laissent le même trou.
L’agent livré à lui-même. La plupart des gens ouvrent un agent de code et se mettent à taper. Ça marche vraiment bien. Mais l’outil est amnésique : si tant de gens publient des montages de « second cerveau » aussi élaborés, c’est justement parce qu’il oublie tout d’une session à l’autre et que tu passes ta vie à réexpliquer le contexte. Tu te retrouves avec un stagiaire brillant qui ne prend jamais la moindre note.
Un autre agent de code. L’open source propose désormais d’excellentes alternatives. OpenCode prend en charge plus de soixante-quinze fournisseurs de modèles ; Aider, intégré nativement à git et fort de plus de quarante mille étoiles, est le chouchou des adeptes du terminal ; Cline vit dans ton éditeur ; OpenHands tourne en totale autonomie dans un bac à sable. Tous fonctionnent avec n’importe quel modèle, et passer à l’un d’eux peut réduire ta facture de modèles d’environ soixante pour cent. Mais regarde bien ce qu’ils sont : des agents de code. Remplacer l’un par l’autre, c’est changer de moteur. Aucun ne te donne une base de connaissances d’entreprise, une couche qui fait respecter les règles de la marque ou un pipeline de contenu. Le plus dur n’a jamais été l’agent.
Un framework multi-agents. Reste l’orchestration : Hermes et consorts, où un agent principal découpe une tâche et lance des workers spécialisés qui lui renvoient des résultats typés. Pour coordonner des agents sur une tâche complexe, c’est puissant. Mais c’est un moteur que tu dois encore câbler toi-même, et il est pensé pour exécuter des tâches ; devenir l’endroit où vit toute ton entreprise, ce n’est pas son rôle. Il ne fait rien pour tes notes de stratégie ni pour ton site.
Même les récits les plus impressionnants que j’ai trouvés, du genre « on fait tourner notre agence sur Claude », reposent sur des montagnes de code d’intégration sur mesure. On y voit un agent d’accueil façon Chief of Staff, des agents qui surveillent les comptes publicitaires, des requêtes en langage naturel sur leurs données, trois ans de bonnes pratiques versées dans un bot de transcription, et l’auteur estime lui-même n’en être qu’à « 0,01 % du chemin ».
Voici ce que ces trois approches m’ont appris : la valeur n’a jamais été dans l’agent. L’agent est devenu interchangeable, tu peux en changer demain. La valeur est dans la structure qui l’entoure. Le wiki qui se souvient. Les skills qui encodent ta façon de travailler. Les liens entre ton savoir, ton code et ton site public. C’est cette structure que j’ai construite, et c’est du texte brut. Elle n’appartient à aucun outil en particulier.
Ce que ça m’apporte
Le détour s’est rentabilisé plus vite que je ne le pensais.
- Le savoir s’accumule au lieu de s’évaporer. Chaque décision, chaque pivot, chaque enseignement tiré d’un client atterrit dans le wiki au moment même où il survient. Je ne redémarre plus jamais à froid.
- Plus aucun écart entre réfléchir et publier. Le cerveau qui porte la stratégie est aussi celui qui écrit l’article de blog et met à jour le site. Pas de copier-coller, pas de changement de contexte, pas de « attends, je te réexplique l’entreprise ».
- La discipline ne dépend plus de la mémoire. Nos règles de nommage et les affirmations qu’on a le droit de faire en public sont inscrites dans les skills. L’agent ne dérape pas en glissant un nom interne dans un article destiné aux clients, parce que la structure ne le laisse pas faire.
- Le travail que je redoutais se fait maintenant tout seul, en arrière-plan. Notes de version, recherche, textes marketing : tout ce qui s’empilait parce qu’il fallait un rituel pour recharger le contexte ne demande plus qu’une phrase pour dire ce que je veux.
Ce qu’il faut pour le mettre en place
Ce qui m’a le plus surpris : c’est presque entièrement du texte.
Le point d’entrée est un unique fichier CLAUDE.md que l’agent lit en premier, à chaque session, comme source de vérité : c’est un comportement natif et documenté, pas une bidouille. Les skills sont des dossiers qui contiennent un fichier Markdown ; aucun code n’est nécessaire. Le wiki, c’est du Markdown. Pour relier tes dépôts, des liens symboliques suffisent : rien ne bouge, rien n’est copié. Et comme tout tient dans de simples fichiers, la même structure fonctionne aussi avec GitHub Copilot. Je garde une copie des instructions là où Copilot va les lire : l’agent qui travaille sur mon code suit donc exactement les mêmes règles que celui qui travaille sur ma stratégie.
Chez moi, tout tourne aujourd’hui sur Claude Code. Mais rien dans la structure n’y est lié. Pointe Copilot, Cursor, OpenCode ou un modèle local vers les mêmes dossiers, et l’entreprise fonctionne exactement pareil, parce qu’elle vit dans les fichiers, pas dans l’agent.
Je te le construis
Je l’ai construit pour moi. Je peux aussi le construire pour toi.
Si tu fais tourner une entreprise sur des agents IA et que tu ressens les mêmes frictions (chaque session qui repart à froid, un savoir coincé dans ta tête, tes outils, ta stratégie et ton marketing qui vivent chacun dans leur monde), c’est exactement le problème que cette structure résout. OwlMeans propose désormais de déployer un système d’exploitation agentique complet pour ton entreprise :
- Sur les agents et les modèles que tu utilises déjà. Claude, Copilot, Cursor, OpenCode, un modèle open-weight auto-hébergé : la structure est conçue pour ne dépendre d’aucun agent. On l’adapte à ta stack, pas l’inverse.
- Il apprend dès le premier jour. Ton wiki commence à faire boule de neige tout de suite ; les skills encodent la façon dont ton équipe travaille vraiment et s’affinent à chaque correction.
- Tout est intégré. Le développement, la stratégie, le contenu et ton site public cessent d’être des chantiers séparés et forment un seul système connecté.
- Il t’appartient. Ce sont de simples fichiers dans tes dépôts. Aucun enfermement, aucune plateforme dont tu dépends, rien à louer. C’est le même principe que notre produit : tu gardes ce qu’on construit.
J’ai passé deux mois à me prouver que la structure l’emporte sur l’outil. Toi, tu peux t’épargner ces deux mois.
OwlMeans est un pipeline de développement IA : décris ce que tu veux sous forme de user stories et obtiens des applications full-stack, des chatbots, des agents IA et des pipelines de données. Typés et prêts pour le SSO, ils restent à toi pour de bon, et tu continues à les faire évoluer avec l’agent de ton choix. Tu veux le même système d’exploitation agentique aux commandes de ton entreprise ? Parlons-en →