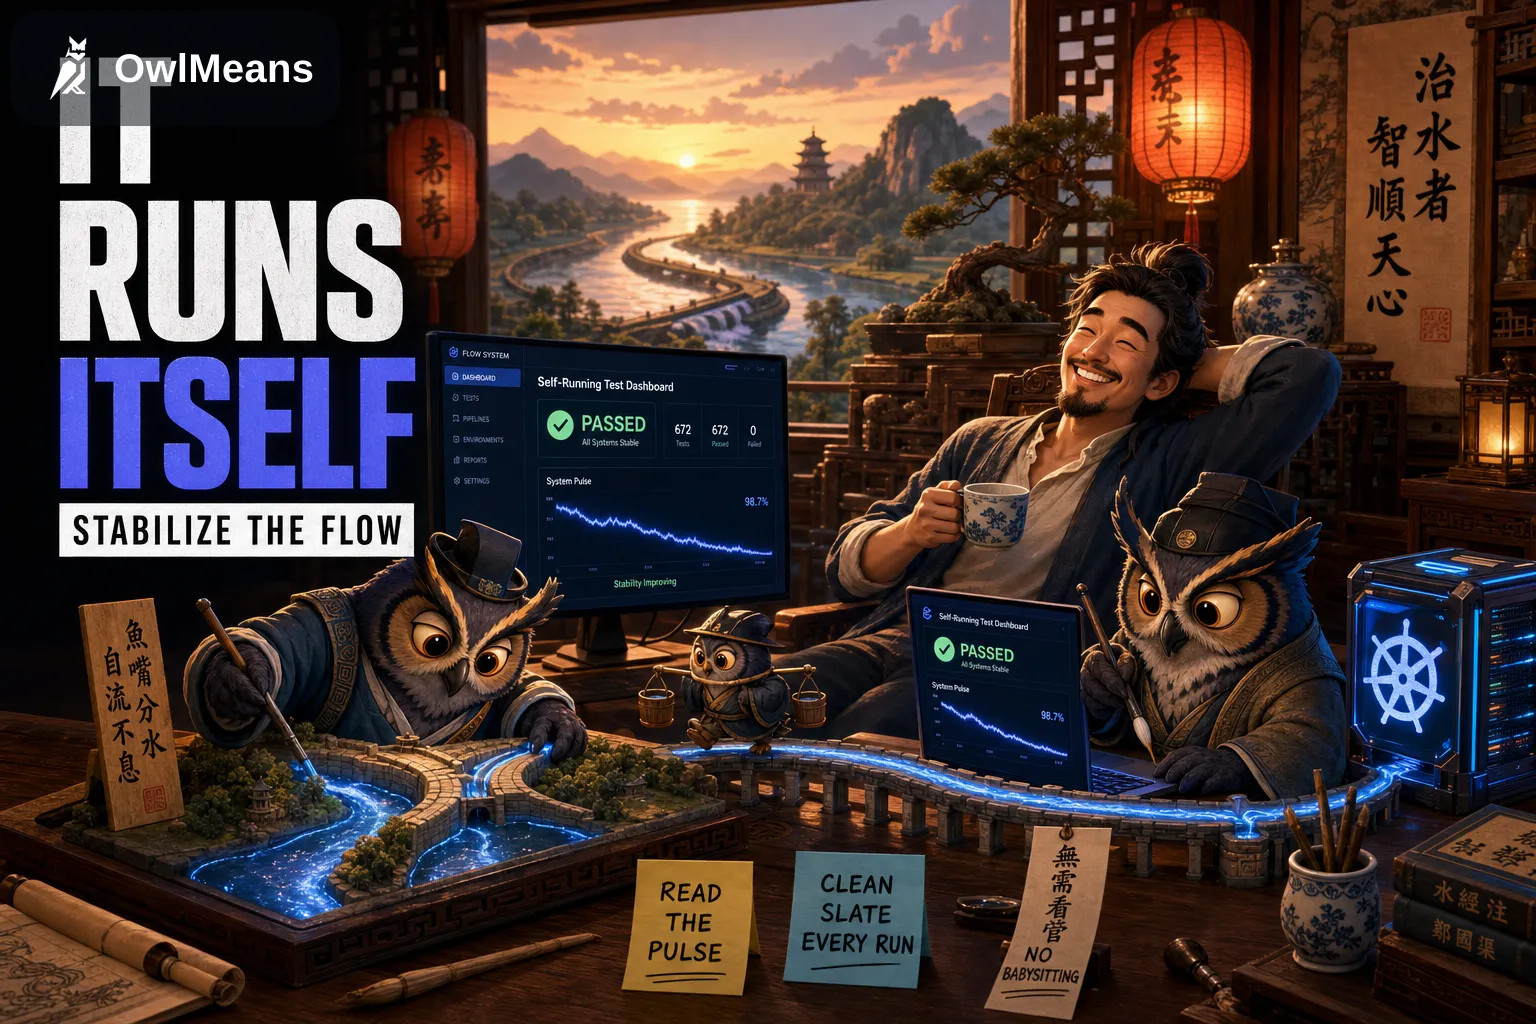
En 256 av. J.-C., un gouverneur nommé Li Bing avait affaire à une rivière qui débordait chaque printemps et noyait les récoltes en aval. La réponse évidente, c’était un barrage. Il n’en a pas construit.
Il a partagé la rivière Min avec une digue de pierre en forme de bouche de poisson, puis laissé ce partage faire le travail : l’essentiel du débit vers les champs à la saison sèche, le surplus renvoyé à la rivière pendant les crues, et le limon emporté avec lui. Ni vannes ni équipe. La rivière s’est régulée toute seule, et elle irrigue encore la plaine de Chengdu, vingt-trois siècles plus tard.
J’ai beaucoup pensé à Li Bing ce mois-ci. Mon test le plus coriace souffrait du même mal que la rivière : il débordait à chaque exécution.
Un courant impossible à simuler
OwlMeans est un pipeline de développement IA : tu décris un produit sous forme de user stories, et des rôles IA spécialisés en font une application full-stack qui t’appartient. Pour tester ça de bout en bout, pas question de mocker quoi que ce soit : il faut faire tourner le vrai système.
Le test inscrit un utilisateur, tape un prompt, attend une spécification, la valide, et vient alors la partie difficile : une sandbox Kubernetes toute neuve démarre pour ce projet, un agent y développe la première story, et le test attend qu’elle soit terminée. Entre dix et quarante minutes, avec de l’asynchrone sous toutes ses formes, et autant de façons d’échouer au hasard. Un état qui traîne d’une exécution précédente, une sandbox à moitié provisionnée, un agent qui se fige, une interface qui change sous tes yeux. La version naïve, c’est un timeout de quatre-vingts minutes et une prière.
La moitié que je n’ai pas écrite
Premier volet de l’astuce : l’essentiel, je ne l’ai pas construit.
Côté navigateur, tout tourne sur notre propre harnais de test, @owlmeans/test-ui, l’une des bibliothèques communes OwlMeans sur lesquelles reposent tous nos projets. Il lance un navigateur, se connecte avec nos clés de superviseur au lieu d’une vraie connexion Google, et encapsule toute la plomberie Playwright pour que mon test ne dise que ce qu’il veut faire.
La sandbox non plus n’avait pas besoin de moi. Une autre bibliothèque commune, @owlmeans/kephemeral, provisionne le slot Kubernetes éphémère (namespace, stockage, déploiement, network policy) et le maintient en vie : elle surveille le pod et le remet sur pied s’il plante. Elle savait déjà tenir debout toute seule.
Il ne restait donc qu’une rivière à dompter : l’attente. Comment dépendre d’un flux qui a toutes les raisons de durer quarante minutes sans le surveiller comme le lait sur le feu ?
La bouche de poisson
Un timeout court ne marche pas : l’agent peut vraiment réfléchir quarante minutes, et c’est normal. Attendre les quatre-vingts minutes pour découvrir qu’il est mort à la troisième ne marche pas non plus. Un minuteur fixe, c’est un barrage : trop bas, ça déborde ; trop haut, ça ne sert à rien.
Alors j’ai arrêté de chronométrer le flux et je me suis mis à prendre son pouls. L’agent dépense des tokens en travaillant, et cette dépense, c’est sa progression elle-même, mesurée à la source. Le test surveille donc le solde de tokens. Toutes les vingt secondes, il vérifie que le solde baisse encore. Si oui, l’agent est vivant : on continue d’attendre, aussi longtemps qu’il le faudra. Si le solde ne bouge plus pendant dix minutes, l’agent est bloqué, et le test échoue sur-le-champ au lieu de fixer le mur une heure de plus.
Toute l’idée est là : c’est le comportement du flux qui me dit s’il se porte bien, comme le courant indique à la digue de Li Bing combien d’eau laisser passer. Trente lignes de code ont fait de mon test le plus capricieux le plus fiable de tous.
Table rase à l’entrée, table rase à la sortie
Il restait une fuite. Une exécution qu’on tue en cours de route laisse derrière elle une sandbox entière (déploiement, stockage, certificats, routes, namespace), et l’exécution suivante trébuche sur l’épave et refuse de démarrer.
Le remède est ennuyeux et radical : avant et après chaque exécution, le test détruit tous les projets de l’unique profil qu’il réutilise. Quelle qu’ait été la fin de l’exécution précédente (sortie propre, plantage, portable refermé), la suivante part d’un état connu et vide. Plus jamais de nettoyage à la main. Repartir de zéro à chaque exécution reste la meilleure arme contre les tests instables, et ici elle ne coûte rien.
L’aqueduc
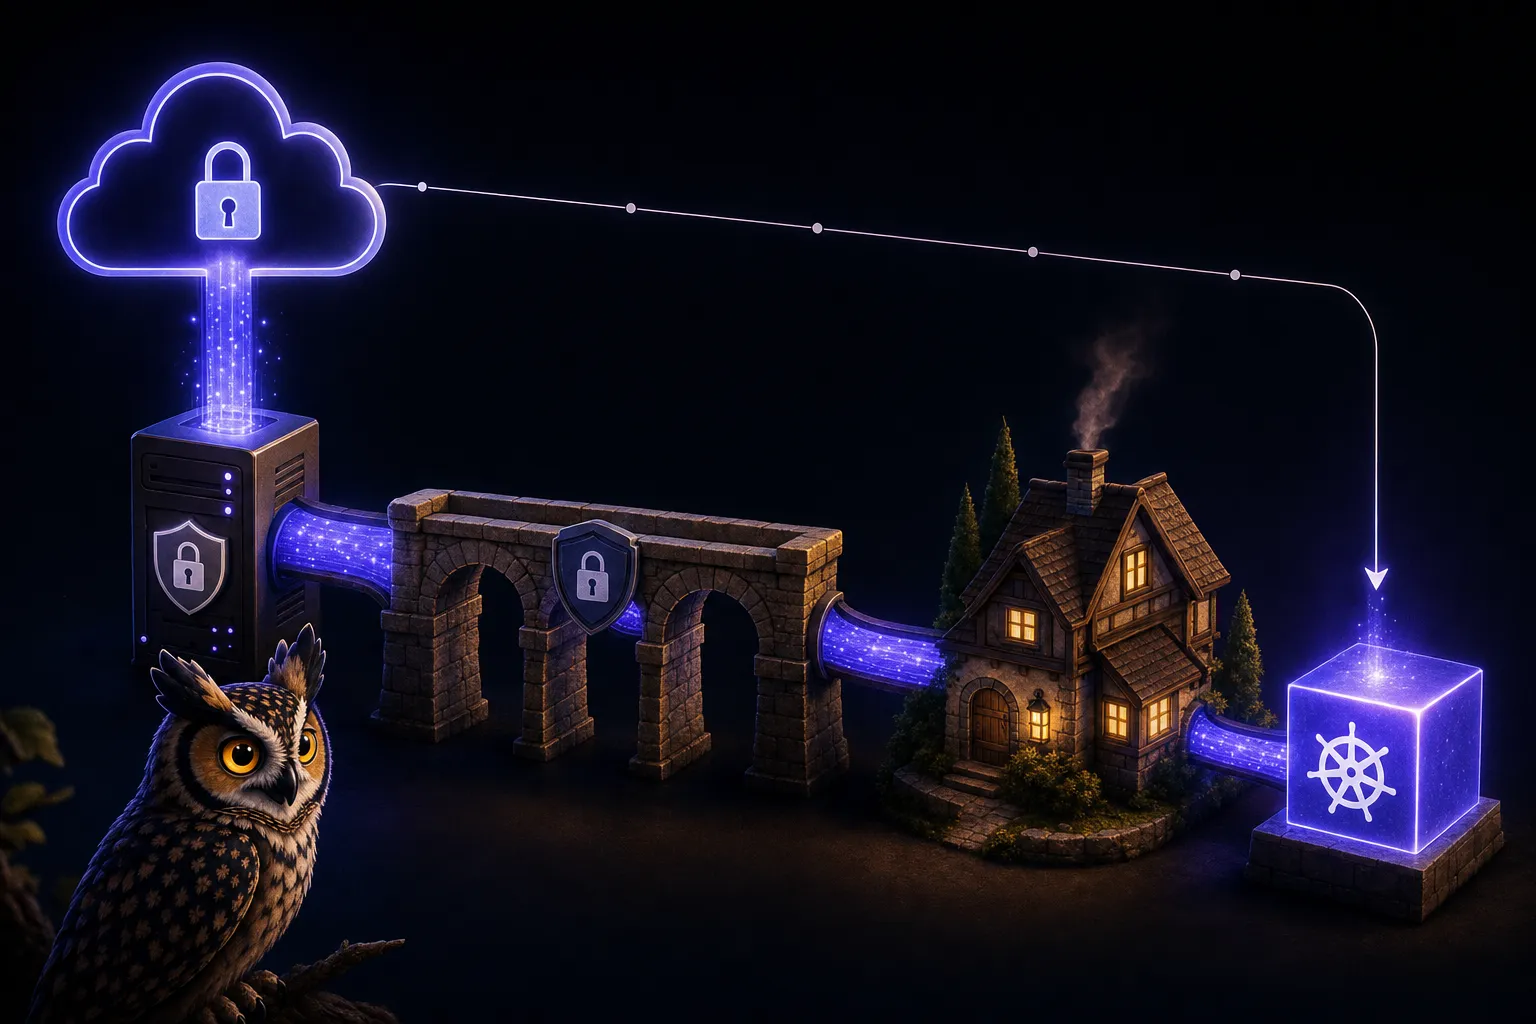
Restait un dernier problème, celui que la plupart des gens ne règlent jamais proprement : le cluster tourne sur un serveur chez moi, sans IP publique, derrière un FAI qui refuse le trafic entrant. Pour le tester de n’importe où et mettre Cloudflare devant, je devais faire sortir le flux de la maison.
C’est un petit projet à part, flt-pf-tnl : une VM cloud bon marché avec une IP statique réservée, qui fait tourner WireGuard et un proxy Nginx. Le trajet est simple : de Cloudflare au relais, puis par un tunnel chiffré jusqu’au serveur domestique, et de là jusqu’à la sandbox Kubernetes. Deux commandes suffisent pour tout monter, avec seulement Terraform, Ansible et quelques scripts shell. Un watchdog revérifie le pare-feu toutes les soixante secondes et corrige la moindre dérive ; l’IP statique survit quand on détruit l’infrastructure, si bien que l’adresse publique ne change jamais.
Je l’ai installé une fois. Il n’est jamais tombé depuis. Un aqueduc : on le construit une fois, et la gravité fait le reste.
Tu peux l’avoir tel quel
Prends un peu de recul. Rien de tout ça n’est exotique : une sandbox qui se répare seule, une boucle de rétroaction qui lit le pouls du flux, un tunnel qui ouvre un cluster privé sur le monde. Quelques jours passés à mettre la bonne structure autour d’un flux qui dévorait mes après-midi. Cette structure, c’est le produit, et c’est la même promesse qu’OwlMeans fait pour chaque application qu’il livre : un monorepo typé et l’infrastructure qui va avec, à toi pour de bon.
Alors voici l’argumentaire honnête.
Si tu construis quoi que ce soit de sérieux, tu vas te heurter à ce mur : des flux lents, des dépendances externes, une sandbox à monter et à démonter, des tests qui passent le lundi et échouent le mardi. Tu peux faire comme moi. Passer des semaines à apprendre qu’un timeout plus long ne répare jamais un flux instable, qu’il faut plutôt lui prendre le pouls, et qu’atteindre ton propre cluster demande un aqueduc. Pour moi, ça valait le coup : c’est mon métier.
Ce n’est pas le tien.
Ça fait partie d’OwlMeans Services : on prend ce harnais, cette sandbox et ce tunnel tels quels, on les adapte à ta stack et on les déploie en quelques jours. Tout t’appartient, le code comme l’infrastructure, sans enfermement chez un fournisseur, et tout se maintient avec n’importe quel agent de code.
Un flux qui tourne tout seul, comme cette rivière depuis vingt-trois siècles. Épargne-toi le mois que j’y ai passé : tu peux l’avoir tel quel.
OwlMeans construit à partir de tes user stories des SaaS TypeScript full-stack typés, prêts pour le SSO, que tu continues à faire évoluer avec l’agent de ton choix. Découvre ce qu’il sait faire →